
NOVO AI · PRAXISLEITFADEN 21 MIN. LESEZEIT
Die Entscheidung auf einen Blick
Fehlalarme bei Maschinenüberwachung prüft man nicht über Bauchgefühl, sondern über ein kurzes, dokumentiertes Abnahmeverfahren. Dafür brauchen Sie vier Dinge: ein klar definiertes Alarmziel, eine kleine, aber belastbare Ground-Truth-Stichprobe, einen sauberen Zeitabgleich zwischen Alarm und realem Ereignis sowie feste Re-Test-Regeln nach Änderungen. Genau daraus entsteht eine Freigabeentscheidung, die im Betrieb nachvollziehbar bleibt.
Wichtig ist die Begriffsdisziplin: Ein Fehlalarm ist nicht einfach nur eine Meldung, die jemand als lästig empfindet. Fachlich kann die Ursache in der Zustandsdefinition, in der Signalqualität, in der zeitlichen Synchronisation, in der Auswertung oder in der Darstellung im Client liegen. Das ist relevant, weil OPC UA Part 9 Alarme und Conditions als zustandsbehaftete Objekte mit eigener Logik beschreibt, nicht als bloße Pop-ups.
Der Beitrag baut auf den vorhandenen Novo-Inhalten auf, ersetzt sie aber nicht. Wenn Sie zuerst die Grundlagen der Zustandsklassifikation nachrüsten oder die Abgrenzung zwischen Produktion, Leerlauf und Störung verstehen möchten, helfen die Beiträge zu automatisch erkannten Maschinenzuständen und zur Stillstandserkennung. Hier geht es enger um die operative Frage nach dem Go-live: Wann ist ein Alarm belastbar genug für den Alltag?
Die wichtigste Einschränkung vorab: Die gelesenen Quellen liefern keine allgemeingültige öffentliche Freigabeschwelle wie etwa eine universelle maximal zulässige Fehlalarmquote. Deshalb ist das folgende Verfahren ausdrücklich eine Empfehlung für die Praxis, keine Norm und kein eigener Benchmark. Außerdem sagen Standardspezifikationen etwas über Modelllogik, aber nichts darüber, welche Teile davon eine konkrete Maschine, ein konkreter Server oder ein konkreter Client tatsächlich implementiert.
01 / PRAXISWISSEN
Fehlalarme bei Maschinenüberwachung: Woran Sie sie nach Go-live erkennen
Nach einem Go-live, einem Sensorwechsel oder einer Modelländerung erscheinen Fehlalarme in der Praxis selten als einzeln dokumentiertes Problem mit klarer Ursache. Sichtbar werden stattdessen Symptome: Die Maschine läuft weiter, aber ein Stillstandsalarm springt an. Ein Alarm bleibt aktiv, obwohl die auslösende Situation beendet ist. Oder die Meldung erscheint erst nach einer Kommunikationsunterbrechung und wirkt dadurch zufällig. Für die Freigabe reicht es nicht, einzelne Beispiele zu sammeln. Sie brauchen eine wiederholbare Prüflogik.
Der erste praktische Schritt ist deshalb nicht die Schwellenwertdiskussion, sondern die saubere Beschreibung des Symptoms. Prüfen Sie je Alarmklasse, ob die Abweichung eher falsch aktiv, falsch inaktiv, zeitlich zu früh, zeitlich zu spät, zu lange aktiv oder nur im Client falsch dargestellt ist. Schon diese Trennung spart Zeit, weil hinter einem verspäteten Alarm andere Ursachen stehen als hinter einem Alarm, der während sichtbarer Produktion auslöst.
Für die Diagnose ist außerdem entscheidend, welchen Alarm Sie überhaupt bewerten. Ein Informationshinweis, ein Eingriffsalarm mit Eskalation an die Instandhaltung und ein automatisch ausgelöster Produktionsstopp dürfen nicht mit derselben Strenge bewertet werden. Je höher die operative Wirkung, desto enger sollte Ihre Freigabe sein. Diese Gewichtung ist kein externer Standard, sondern eine betriebliche Risikoentscheidung, die Sie vor dem Re-Test schriftlich festlegen sollten.
Wenn die Datengrundlage noch unscharf ist, starten Sie nicht mit allen Alarmen. Wählen Sie die zwei bis drei Meldungen aus, die konkrete Entscheidungen auslösen oder im Team strittig sind. Das entspricht auch dem Pilotgedanken der Novo-Lösungsseite zur Maschinendatenerfassung für Bestandsmaschinen: erst Erkennung und Datenqualität prüfen, dann skalieren.
Symptomorientierte Ersteinschätzung für Fehlalarme
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Wahrscheinliche Ebene
Signal, Schwelle, falsche ZustandsklasseAls Erstes prüfen
Rohsignal, Sensorlage, Ausschluss geplanter Phasen, Ground Truth derselben SchichtFolge für den Re-Test
Betroffene Maschine, Produktvariante und Schicht erneut bewertenWahrscheinliche Ebene
Zustandsmodell, Retain- oder Branch-Logik, Client-SynchronisationAls Erstes prüfen
Aktiv/Inaktiv-Übergänge, Retain, BranchId, Refresh-VerhaltenFolge für den Re-Test
Gesamten Lebenszyklus des Alarmereignisses testen, nicht nur den AuslösepunktWahrscheinliche Ebene
Zeitbezug und SynchronisationAls Erstes prüfen
SourceTimestamp, Kommunikationsstatus, Refresh-Prozess, Zeitzonen und PufferspeicherFolge für den Re-Test
Test mit definiertem Verbindungsabbruch und Wiederanlauf wiederholenWahrscheinliche Ebene
Modell- oder ProzessdriftAls Erstes prüfen
Neue Referenzdaten, geänderte Zyklen, neue BetriebszuständeFolge für den Re-Test
Freigabe nur für alte und neue Varianten getrennt erteilenHilfreich ist außerdem die Gegenfrage: Was gilt ausdrücklich nicht als Fehlalarm? Wenn ein Alarm bewusst auf eine grobe Zustandsklasse reagiert, etwa auf jede Unterbrechung der Bearbeitung, dann ist eine Meldung während einer nicht ausgeschlossenen Unterbrechung fachlich kein Fehlalarm. Sie kann betrieblich unerwünscht sein, bleibt aber zunächst ein Problem der Alarmdefinition oder der Freigaberegel. Diese Unterscheidung verhindert, dass das Team eine fachlich richtige Meldung mit dem falschen Kriterium ablehnt.
02 / PRAXISWISSEN
Wo Fehlalarme wirklich entstehen
Fehlalarme wirken im Betrieb leicht wie ein Problem der Oberfläche. Für die technische Prüfung sollten Sie die Ursache jedoch auf vier Ebenen auseinanderhalten: Zustandsmodell, Eingangssignal, Zeitbezug und Darstellung. Wer diese Ebenen nicht trennt, ändert zu früh Schwellen oder Benachrichtigungen und verschiebt das Problem nur an eine andere Stelle.
Zustandsmodell und Alarmobjekt trennen
Ein Alarm sollte auf einem klar beschriebenen Zustand oder Zustandsübergang basieren. OPC UA Part 9 beschreibt Conditions als Repräsentation des Zustands eines Systems oder seiner Komponenten und Alarme als Spezialisierung mit Active- und Inactive-Logik. Für die Praxis heißt das: Prüfen Sie zuerst, ob der Alarm an die richtige fachliche Bedingung gebunden ist. Ein falsch definierter Zielzustand lässt sich nicht mit besseren Sensoren reparieren.
Ein typischer Fehler ist die Vermischung von Maschinenzustand und Ursache. Ein Alarm soll ungeplanten Stillstand melden, wird aber faktisch schon bei jedem Zustand ohne Werkstückbewegung aktiv. Dann ist nicht der Alarm zu sensibel, sondern die Zustandsdefinition zu grob. Für ältere Bestandsmaschinen ist diese Trennung wichtig, weil externe Signale Zustände unterscheiden können, während Ursachen erst mit zusätzlichem Kontext eindeutig werden.
Die Novo-Lösungsseite beschreibt genau diese Grenze: Externe Akustik- und Vibrationssignale können Maschinenzustände unterscheiden, erklären aber nicht automatisch jeden Stillstandsgrund. Wenn diese fachliche Grenze im Projekt übersehen wird, werden aus unklaren Ursachen schnell vermeintliche Fehlalarme. Das Problem liegt dann nicht zwingend im Modell, sondern in einer Erwartung, die der Alarm fachlich nicht erfüllen sollte.
Signale, Qualität und Zeitbezug prüfen
Der zweite Entstehungsort ist die Qualität der Alarmbasis. OPC UA Part 9, Modellbeschreibung führt dafür eigene Elemente wie Quality und SourceTimestamp. Das ist fachlich nützlich, weil ein Alarm auf unsicherer Signalbasis nicht dieselbe Aussagekraft hat wie ein Alarm auf sauberem, zeitlich eindeutigem Eingang. In der Praxis lohnt sich daher die einfache Frage: Kam die Entscheidung aus gültigen Daten, und ist der Zeitstempel plausibel?
Bei nachgerüsteter Überwachung sind kleine Zeitverschiebungen kritisch. Wenn Sensordaten lokal verarbeitet, Betriebszustände zeitlich aggregiert und Alarme später in einem Client dargestellt werden, kann dieselbe physische Situation in mehreren Zeitbezügen auftauchen. Das ist nicht automatisch ein Fehler. Ein Prüfproblem entsteht erst, wenn Ihr Abgleich nicht klar festlegt, welcher Zeitstempel für die Freigabe maßgeblich ist.
Für Novo ist hier nur belegt, dass WatchMen aus externen Signalen zeitliche Zustandsverläufe und Auswertungen bildet und dass der AVA-Sensor Akustik und Vibration erfasst. Öffentliche Aussagen zu allgemeinen SourceTimestamp- oder Quality-Feldern einzelner Alarmobjekte liegen in den gelesenen Novo-Seiten nicht vor. Solche Details dürfen Sie daher nicht voraussetzen, sondern müssen sie im Projekt konkret prüfen.
Synchronisation statt Bedienfehler-Vermutung
Ein dritter Entstehungsort ist die Synchronisation zwischen Server, Subscription und Anzeige. OPC UA Part 9 weist ausdrücklich darauf hin, dass Clients den aktuellen Zustand per Refresh anfordern können, weil beim reinen Einstieg in eine Event-Subscription der bestehende Zustand nicht automatisch komplett gemeldet wird. Wenn ein Team diese Logik nicht berücksichtigt, werden Altzustände, Doppelmeldungen oder scheinbar hängende Alarme leicht als Modellfehler fehlgedeutet.
Wenn Diskussionen über Fehlalarme an Neustarts, Netzwerkunterbrechungen oder Client-Wechsel gebunden sind, lohnt sich die Prüfung von Refresh, Retain und gegebenenfalls BranchId vor jeder Modelländerung. Sonst überarbeiten Sie die Klassifikation, obwohl die eigentliche Ursache in der Ereignissynchronisation liegt. Genau deshalb gehört ein Kommunikations- und Neustartfall in jedes Abnahmeprotokoll.
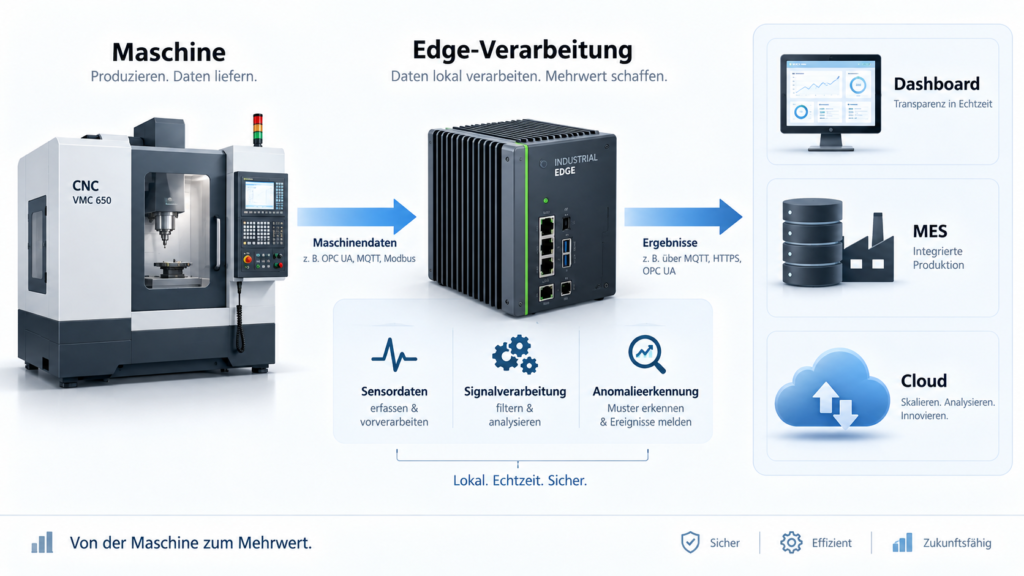
Die folgende Grafik passt an dieser Stelle, weil sie den Unterschied zwischen Signalquelle, lokaler Verarbeitung und weiterführenden Systemen veranschaulicht. Für Fehlalarme ist diese Trennung keine Architekturfrage um ihrer selbst willen, sondern der kürzeste Weg zur Ursachenbegrenzung.
Standardumfang ist nicht Implementierungsnachweis
Ein zusätzlicher Prüfpunkt wird in Projekten leicht übersehen: Aus dem Umfang einer Spezifikation folgt nicht automatisch, welche Daten Ihre Maschine oder Ihr Client tatsächlich liefert. OPC UA Part 9 beschreibt ein Informationsmodell mit Zuständen, Retain-, Refresh- und Qualitätslogik. Ob ein konkreter Server diese Teile anbietet, wie er sie befüllt und wie ein konkreter Client sie darstellt, ist eine Frage der Implementierung. Für die Abnahme heißt das: Erst prüfen, dann voraussetzen.
Diese Trennung schützt auch vor falschen Retrofit-Erwartungen. Wenn eine Maschine keine nutzbare interne Alarmsemantik liefert, kann eine nachgerüstete Lösung trotzdem Zustände erkennen und visualisieren. Daraus folgt aber nicht, dass automatisch dieselben Modellfelder, Zeitstempel oder Quittierungsabläufe vorliegen wie in einer standardnahen OPC-UA-Implementierung. Ihr Datenvertrag sollte deshalb ausdrücklich zwischen Standardbegriffen und tatsächlich vorhandenen Projektfeldern unterscheiden.
03 / PRAXISWISSEN
Das Abnahmeprotokoll für Fehlalarme bei Maschinenüberwachung
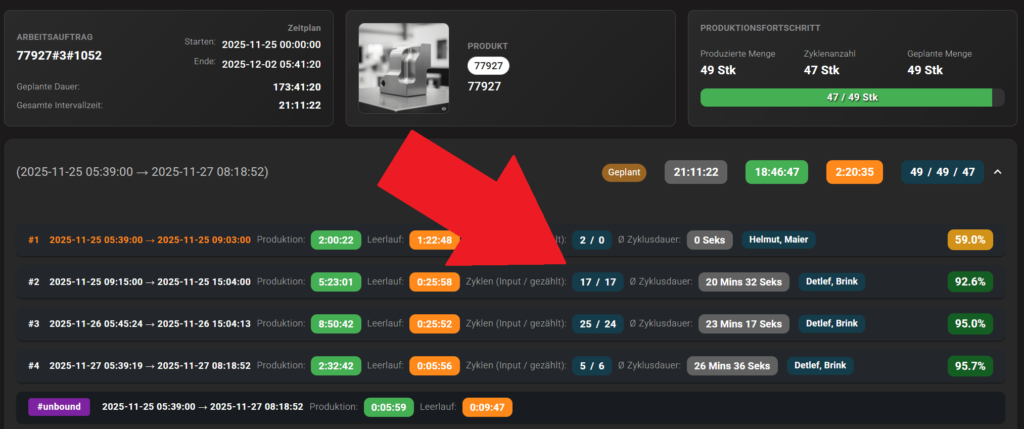
Der praktische Kern dieses Beitrags ist ein kurzes, wiederholbares Abnahmeprotokoll. Es dient nicht dazu, perfekte Statistik aufzubauen, sondern belastbare Freigaben nach Änderungen zu ermöglichen. Wenn Sie den Ablauf schriftlich festlegen, können Produktion, Instandhaltung und IT denselben Alarm mit derselben Prüflogik bewerten. Genau das fehlt in vielen Einführungsprojekten nach dem ersten Go-live.
Schritt 1: Bewertungsraum und Alarmziel festlegen
Definieren Sie zuerst, in welchem Zeitraum der Alarm überhaupt bewertet werden darf. Das ist entscheidend, weil die Fehlalarmquote sonst beliebig wird. Für einen Stillstandsalarm sollten geplante Pause, geplanter Rüstvorgang und bewusste Stillsetzung nur dann in die Bewertung eingehen, wenn der Alarm genau diese Zustände adressieren soll. Wenn nicht, gehören sie aus dem Bewertungsraum ausgeschlossen.
Schreiben Sie außerdem in einem Satz auf, welches reale Ereignis der Alarm markieren soll. Ein sauberes Beispiel wäre: Alarm A meldet ungeplanten Stillstand, wenn Maschine X innerhalb der bewerteten Beobachtungszeit mindestens Y Sekunden nicht im Produktionszustand ist und keine geplante Unterbrechung vorliegt. Erst mit so einem Satz können Sie Ground Truth, Re-Test und Freigabe konsistent halten.
Diese Vorarbeit verhindert auch einen typischen OEE-Fehler: Verschiedene Teams verwenden denselben Begriff für unterschiedliche Zeitnenner. Die Novo-Lösungsseite zur Maschinendatenerfassung weist darauf hin, dass Verfügbarkeit und OEE nur mit klar definierter Bezugszeit belastbar werden. Für die Alarmprüfung gilt dieselbe Disziplin. Ohne eindeutig ausgeschlossene Phasen wird die Fehlalarmquote rechnerisch sauber, aber operativ wertlos.
Schritt 2: Ground Truth stichprobenartig erfassen
Erheben Sie anschließend eine kleine Referenzstichprobe realer Ereignisse. Dafür brauchen Sie keine monatelange Studie. Für eine operative Freigabe können Sie eine gezielt zusammengestellte Stichprobe über mehrere repräsentative Situationen anlegen: normale Produktion, Schichtwechsel, Neustart nach kurzer Unterbrechung, bekannte Problemphase, neues Produkt oder neues Werkzeug. Entscheidend ist, dass die Referenz unabhängiger erfasst wird als der Alarm selbst.
Als Ground Truth eignen sich je nach Anlage direkte Beobachtung, zeitgestempelte Bedienerprotokolle, Maschinenmeldungen, Stückzahlsprünge, Kamerabilder oder eine Kombination daraus. Welche Quelle führend ist, müssen Sie vorab festlegen. Wenn dieselbe Sensorik sowohl den Alarm als auch die Referenz bildet, testen Sie nur sich selbst. Das ist für eine schnelle Plausibilisierung brauchbar, aber nicht für eine belastbare Freigabe.
Für die Stichprobengröße gibt es in den gelesenen Quellen keine öffentliche Norm. Meine Empfehlung für eine erste Betriebsfreigabe lautet daher ausdrücklich nur als Praxisregel: je geänderter Zustandsklasse mindestens 20 bestätigte Alarmfälle und 20 bestätigte Nicht-Ereignis-Fenster erfassen. Wenn das Zielereignis im Beobachtungszeitraum kaum vorkommt, verlängern Sie die Beobachtungsdauer, statt mit sehr kleinen Stichproben scheinbar gute Quoten zu produzieren.
Schritt 3: Alarm und Ereignis zeitlich abgleichen
Im dritten Schritt legen Sie eine eindeutige Matching-Regel fest. Für viele Teams ist ein Abgleich über denselben Zeitraster praktisch, etwa 10-Sekunden-, 30-Sekunden- oder 1-Minuten-Fenster. Dann markieren Sie pro Fenster, ob laut Ground Truth das Zielereignis vorlag und ob der Alarm aktiv war. Das ist leichter zu prüfen als freie Interpretationen einzelner Zeitstempel und macht spätere Re-Tests vergleichbar.
Wenn Ihr System zustandsbehaftete Alarmobjekte mit Active-, Inactive-, Retain- oder Branch-Information liefert, dokumentieren Sie zusätzlich, ob Sie Zustandswechsel oder den reinen Aktivzustand bewerten. Das ist wichtig, weil ein Alarm fachlich korrekt aktiv sein kann, aber im Client nach einem Refresh anders dargestellt wird. OPC UA Part 9 beschreibt genau diese Trennung zwischen aktuellem und erneut synchronisiertem Zustand.
Führen Sie den Abgleich nicht nur für ruhige Produktionsphasen durch, sondern gezielt auch um Schichtstarts, Produktwechsel, Netzunterbrechung, Restart und kurze Unterbrechungen herum. Dort wechseln Kontext, Datenfluss oder Zustandsgrenzen. Wenn Sie für diese Zustände noch kein gemeinsames Begriffsverständnis haben, hilft ergänzend der Novo-Beitrag zur Stillstandserkennung bei der Trennung von geplanter und ungeplanter Unterbrechung.
Schritt 4: Fehlalarmquote und Zusatzmetriken berechnen
Die Kernmetrik für diesen Beitrag ist die Fehlalarmquote im Sinn des False Positive Rate. Das NIST-Glossar definiert den Begriff als Anteil bekannter Nicht-Treffer, die fälschlich als Treffer bestimmt werden. Übertragen auf die Maschinenüberwachung heißt das: Wie viele bekannte Nicht-Ereignis-Fenster wurden trotzdem alarmiert? Die Formel lautet Fehlalarmquote = falsch alarmierte Nicht-Ereignis-Fenster / bekannte Nicht-Ereignis-Fenster × 100.
Neben dieser Kernmetrik empfehle ich zwei Zusatzwerte, allerdings ausdrücklich als abgeleitete Praxiskennzahlen und nicht als NIST-Standard: erstens die Erkennungsquote innerhalb der echten Ereignisfenster und zweitens die Präzision der ausgelösten Alarmfenster. Die Fehlalarmquote zeigt, wie viel unnötiges Rauschen Sie erzeugen. Die Erkennungsquote zeigt, wie viel vom realen Problem Sie überhaupt treffen. Die Präzision zeigt, wie viel Vertrauen ein ausgelöster Alarm verdient.
Eine einzige Quote genügt also nicht. Ein Alarm mit null Fehlalarmen, der gleichzeitig viele echte Ereignisse verpasst, ist für den Betrieb ebenso ungeeignet wie ein Alarm mit hoher Erkennung, aber permanentem Rauschen. Deshalb sollte Ihre Freigabeentscheidung immer aus mindestens zwei Blickwinkeln bestehen: Stört der Alarm unnötig, und erfasst er das fachlich relevante Ereignis ausreichend?
Schritt 5: Ursache klassifizieren und Maßnahme zuordnen
Nach der Berechnung beginnt die eigentliche Diagnose. Ordnen Sie jeden Fehlalarm einer Ursache zu, nicht nur einem Zähler. Eine praktikable Einteilung besteht aus fünf Klassen: Zustandsdefinition falsch, Sensor- oder Rohsignalproblem, Zeit- oder Synchronisationsproblem, fehlender Prozesskontext, Prozess- oder Modelländerung. Diese Zuordnung ist kein Selbstzweck. Erst dadurch wird aus einer Quote eine konkrete Änderungsmaßnahme mit passendem Re-Test-Umfang.
Wenn mehrere Fehlalarme derselben Klasse entstehen, ändern Sie nur eine Ursache pro Re-Test-Runde. Wer gleichzeitig Sensorlage, Schwellen und Zeitfenster ändert, kann hinterher kaum belegen, welcher Eingriff die Verbesserung gebracht hat. Dieses Änderungsprotokoll ist besonders wertvoll, wenn das Team später neue Varianten aufschaltet oder die Alarmdiskussion Monate später erneut beginnt.
Praktisches Abnahmeprotokoll für eine Freigabeentscheidung
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Festlegung
Eindeutige Definition des Zielereignisses und der ausgeschlossenen PhasenNachweis
Schriftliche Alarmkarte mit Beispielen und GegenbeispielenFreigabefrage
Ist fachlich klar, wofür der Alarm steht und wofür nicht?Festlegung
Unabhängige Referenzquelle und dokumentierte BeobachtungsfensterNachweis
Beobachtungsprotokoll, Maschinenmeldung oder VideovermerkFreigabefrage
Ist die Referenz unabhängig genug für eine belastbare Prüfung?Festlegung
Fester Zeitraster und definierte Toleranz bei Start und EndeNachweis
Abgleichdatei oder AuswertungstabelleFreigabefrage
Würden zwei Personen dieselben Fenster gleich bewerten?Festlegung
Fehlalarmquote plus mindestens eine ErgänzungsmetrikNachweis
Formel, Zählerstände, RechenschritteFreigabefrage
Ist die Quote für die Alarmwirkung im Betrieb akzeptabel?Festlegung
Nur eine Ursachenklasse pro Re-Test-Runde ändernNachweis
Version, Datum, Verantwortlicher, betroffene MaschinenFreigabefrage
Kann das Team Verbesserungen eindeutig auf eine Änderung zurückführen?Die Abnahme wird belastbarer, wenn Sie die Ergebnisse gemeinsam mit der Zustandslogik ansehen. In der Novo-Fallstudie zur CNC-Überwachung in der Präzisionswerkzeugfertigung wird sauber zwischen Sensorinstallation, Signallernen und Validierung der Zustände unterschieden. Genau diese Trennung sollten Sie auch für Fehlalarmprüfungen übernehmen: Montage ist nicht Validierung, und Validierung ist nicht automatisch Freigabe.
04 / PRAXISWISSEN
Beispielrechnung: Fehlalarmquote sauber berechnen
Das folgende Szenario ist ausdrücklich nur ein Rechenbeispiel mit Annahmen, kein gemessenes Kundenergebnis. Es zeigt, wie Sie die Begriffe konsistent halten. Bewertet wird ein ungeplanter Stillstandsalarm auf einer Schicht mit 480 Minuten. Davon sind 30 Minuten Pause und 40 Minuten geplanter Rüstvorgang aus der Bewertung ausgeschlossen, weil der Alarm diese Phasen nicht melden soll.
Damit bleiben 410 Minuten bewertete Beobachtungszeit. In dieser Zeit markiert die Ground Truth 50 Minuten echten ungeplanten Stillstand und 360 Minuten bekannte Nicht-Ereignisse. Die Auswertung erfolgt in 1-Minuten-Fenstern. Der Alarm war in 62 Fenstern aktiv. Davon überlappten 46 Fenster mit echtem Stillstand. 16 alarmierte Fenster fielen in bekannte Nicht-Ereignis-Zeiten.
Die Fehlalarmquote berechnen Sie dann mit der NIST-Logik als Anteil falsch alarmierter Nicht-Ereignis-Fenster an allen bekannten Nicht-Ereignis-Fenstern: 16 / 360 × 100 = 4,44 %. Ergänzend ergibt sich eine Erkennungsquote von 46 / 50 × 100 = 92,00 %. Die Präzision der ausgelösten Alarmfenster liegt bei 46 / 62 × 100 = 74,19 %. Zusammen ergibt das ein deutlich aussagekräftigeres Bild als nur die absolute Alarmanzahl.
Wichtig ist die Sensitivität gegenüber kleinen Stichproben. Wenn bei ansonsten gleichen Bedingungen sechs zusätzliche Fehlalarmfenster auftreten, steigt die Fehlalarmquote sofort auf 22 / 360 × 100 = 6,11 %. Genau deshalb ist eine zu kleine Referenz riskant. Ein einzelnes falsch klassifiziertes Fenster kann die Freigabe spürbar verschieben, ohne dass sich der Betrieb real wesentlich verändert hat.
Aus diesem Beispiel folgt keine allgemeingültige Freigabeschwelle. Es zeigt nur, wie Sie rechnen und argumentieren sollten. Für Alarmklassen mit höherer operativer Wirkung können Sie vor dem Test eine strengere Akzeptanzregel festlegen als für reine Informationsanzeigen. Wichtig ist, dass diese Differenz vor dem Test definiert ist und nicht nachträglich passend gemacht wird.
Beispielrechnung mit Annahmen für einen Stillstandsalarm
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Wert
480 minFormel
gegebenHinweis
Bezugszeit der SchichtWert
410 minFormel
480 - 30 - 40Hinweis
Pause und geplanter Rüstvorgang ausgeschlossenWert
50 minFormel
Ground TruthHinweis
Zielereignis innerhalb der BewertungszeitWert
360 minFormel
410 - 50Hinweis
Nenner für die FehlalarmquoteWert
16 minFormel
AbgleichHinweis
Alarm aktiv, aber kein Zielereignis vorhandenWert
4,44 %Formel
16 / 360 × 100Hinweis
Kernmetrik nach NIST-LogikWert
92,00 %Formel
46 / 50 × 100Hinweis
Abgeleitete ZusatzmetrikWert
74,19 %Formel
46 / 62 × 100Hinweis
Abgeleitete Zusatzmetrik05 / PRAXISWISSEN
Re-Test nach Go-live, Sensorwechsel oder Modelländerung
Ein Alarm wird nicht einmal geprüft und dann für immer freigegeben. Re-Tests sind immer dann nötig, wenn sich die fachliche Aussagekraft des Alarms ändern kann. Das betrifft deutlich mehr als nur ein neu trainiertes Modell. Schon ein anderer Montageort des Sensors, eine veränderte Taktung, neue Werkzeugkombinationen oder ein geänderter Ausschluss geplanter Phasen können das Verhältnis zwischen Signal und Zielereignis verschieben.
Was einen Re-Test zwingend auslöst
Als zwingenden Re-Test würde ich mindestens folgende Änderungen behandeln: Sensorwechsel oder neue Sensorposition, geänderte Signalkette oder Sampling, neue Schwellen oder Entscheidungslogik, Umstellung des Zielzustands, anderes Zeitfenster für Alarmaktivierung, neues Produkt mit abweichendem Bewegungs- oder Geräuschmuster, Modell-Retraining auf neuen Daten sowie jede relevante Änderung an Zeitstempeln, Puffern oder Kommunikationswegen.
Der Grund dafür ist methodisch einfach. Die Fraunhofer-Seite zum automatisierten Condition Monitoring beschreibt selbstlernende Überwachung als Vergleich zwischen Prozessmodell und tatsächlichem Prozesslauf. Wenn sich Signal oder Prozesslauf ändern, muss geprüft werden, ob das gelernte oder regelbasierte Muster noch zur Realität passt. Ohne diese Rückkopplung wird aus einem formal unveränderten Alarm faktisch ein neuer Alarm.
Wann eine Teilfreigabe reicht
Nicht jede Änderung verlangt einen Volltest auf allen Maschinen. Wenn nur die Darstellungsbezeichnung, die Benachrichtigungsempfänger oder die Priorisierung geändert werden, reicht ein Teiltest der Anzeige- und Weiterleitungskette. Das gilt aber nur, solange Auslösebedingung, Zeitbasis und Datenquelle unverändert bleiben. Sobald eine Änderung das fachliche Matching zwischen Alarm und Zielereignis berührt, genügt ein reiner Oberflächentest nicht mehr.
Praktisch heißt das: Führen Sie den Re-Test immer entlang der betroffenen Wirkungsebene durch. Eine neue Schwelle braucht Ground Truth und Kennzahlen. Eine neue Eskalationsregel braucht zusätzlich einen Prozess- und Empfängertest. Ein neuer Sensorstandort braucht erneut die Prüfung der Unterscheidbarkeit der Zustände. Ein Kommunikationsumbau braucht Zeit- und Synchronisationstest inklusive Wiederanlauf.
Wann Sie neu baselinen sollten
Eine neue Baseline ist sinnvoll, wenn sich der Normalbetrieb selbst verändert hat. Beispiele sind ein anderes Werkzeugkonzept, neue Materialvarianten, veränderte Taktfolgen, ein Umzug der Maschine, geänderte Einhausung, neue Schichtmuster oder eine veränderte Reihenfolge von Aufträgen. Dann bringt es wenig, nur alte Grenzwerte nachzujustieren. Sie brauchen neue Referenzdaten für das, was jetzt als normal gelten soll.
Öffentlich dokumentierte Novo-Seiten unterstützen diesen Gedanken indirekt: Die Lösungsseite empfiehlt, im Pilot Erkennung und Datenqualität zu prüfen, bevor weitere Anlagen angebunden werden. Die CNC-Fallstudie trennt die Lern- und Validierungsphase von der späteren Nutzung. Daraus folgt keine universelle Novo-Funktion zur automatischen Re-Test-Steuerung, wohl aber ein sauberer Projektgrundsatz: erst neue Datenlage prüfen, dann skalieren.
Wenn eine Plattformansicht zur Alarmregelkonfiguration hilfreich ist, kann ein Video die Verantwortlichkeiten im Re-Test verständlicher machen. Für diesen Beitrag wurde das vorhandene Video nur anhand von Titel und Metadaten bewertet, nicht inhaltlich transkribiert.
06 / PRAXISWISSEN
Dokumentationsvergleich, kein eigener Praxistest
Der folgende Vergleich ist ein Dokumentationsvergleich, kein eigener Praxistest. Er zeigt, was in den gelesenen öffentlichen Quellen zu Zustandsmodell, Zeitbezug, Validierung und Integration tatsächlich dokumentiert ist. Novo AI veröffentlicht diesen Beitrag und ist selbst Anbieter. Dieser Interessenkonflikt gehört offen dazu. Deshalb werden fehlende öffentliche Angaben ausdrücklich als unbekannt markiert und nicht als fehlende Funktion interpretiert.
Der Vergleich ist für die Diagnose nützlich, weil unterschiedliche Werkzeuge unterschiedliche Ebenen adressieren. Ein standardisiertes Alarmmodell hilft bei Zustands- und Synchronisationsfragen. Ein lernendes Condition-Monitoring-System hilft bei Prozessmodell-Abweichungen. Eine Retrofit-Lösung hilft, wenn die Maschine selbst keine brauchbare Schnittstelle liefert oder wenn externer Signalzugang der pragmatischere Start ist.
Öffentlich dokumentierter Vergleich: Novo AI, Fraunhofer CMS und OPC UA Part 9
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Novo AI WatchMen
Ja. Die gelesenen Novo-Seiten beschreiben die Unterscheidung von Produktion, Leerlauf und Stillstand sowie deren Validierung im Pilot. Quelle, Quelle.Fraunhofer IOSB-INA self-learning CMS
Ja. Die Seite beschreibt ein gelerntes Prozessmodell, das mit dem tatsächlichen Prozesslauf verglichen wird, um Anomalien und Fehler zu erkennen. Quelle.OPC UA Part 9 Alarms & Conditions
Ja. Conditions und Alarms werden als zustandsbehaftete Informationsmodelle mit Active-, Enabled-, Ack- und weiteren Zuständen beschrieben. Quelle.Novo AI WatchMen
Ja, teilweise. WatchMen beschreibt zeitliche Verläufe und Auswertungen von Maschinenzuständen; konkrete öffentliche Felder wie SourceTimestamp sind in den gelesenen Novo-Seiten nicht spezifiziert. Quelle.Fraunhofer IOSB-INA self-learning CMS
Ja. Die Seite nennt Echtzeitüberwachung und Speicherung der benötigten Daten in einer Time Series Database. Quelle.OPC UA Part 9 Alarms & Conditions
Ja. Das Modell dokumentiert unter anderem TransitionTime, EffectiveTransitionTime und SourceTimestamp. Quelle.Novo AI WatchMen
Öffentlich auf den gelesenen Novo-Seiten nicht dokumentiert. Für konkrete Projekte muss geprüft werden, wie Alarmzustände synchronisiert und dargestellt werden. Quelle.Fraunhofer IOSB-INA self-learning CMS
Öffentlich auf der gelesenen Fraunhofer-Seite nicht dokumentiert. Die Seite beschreibt Fehlererkennung in Echtzeit, aber keine allgemeine Quality- oder Refresh-Semantik. Quelle.Novo AI WatchMen
Ja. Novo dokumentiert Pilotprüfung von Erkennung und Datenqualität sowie eine Lern- und Validierungsphase in der CNC-Fallstudie. Quelle, Quelle.Fraunhofer IOSB-INA self-learning CMS
Ja. Die Seite beschreibt das automatische Lernen eines Prozessmodells aus Prozessdaten, nennt aber keine öffentliche Freigabeschwelle für Fehlalarme. Quelle.OPC UA Part 9 Alarms & Conditions
Nicht als Rolloutvorgehen. Die Spezifikation dokumentiert das Informationsmodell, nicht das betriebliche Freigabeverfahren. Quelle.Novo AI WatchMen
Ja. Externe Sensorik ohne direkten SPS-Zugriff ist dokumentiert; ERP/BDE-Anbindung muss separat geprüft werden. Quelle.Fraunhofer IOSB-INA self-learning CMS
Ja. Genannt werden Connectoren wie OPCUA, MQTT und Profinet sowie eine Integration in bestehende Automatisierungssysteme. Quelle.OPC UA Part 9 Alarms & Conditions
Als Standard ja, als konkrete Produktintegration nein. Die Spezifikation definiert das Modell, nicht die Nachrüstung an einzelnen Maschinen. Quelle.Wann ist eine andere Lösung geeigneter? Wenn Sie bereits ein gut gepflegtes OPC-UA-basiertes Alarmmanagement mit Audit-Trail, sauberem Refresh-Verhalten und belastbaren Zeitstempeln betreiben, sollten Sie Fehlalarme zuerst dort analysieren, statt neue Signalwege aufzubauen. Wenn Ihr Hauptproblem dagegen in komplexen Prozessabläufen über mehrere Automatisierungssysteme liegt, kann ein lernendes, connectorbasiertes System wie das von Fraunhofer beschriebene CMS fachlich näher an der Aufgabe liegen als eine reine Nachrüstung einzelner Maschinen.
07 / PRAXISWISSEN
Was in die Freigabeakte gehört
Ein Re-Test ist nur dann dauerhaft nützlich, wenn die Entscheidung Monate später noch nachvollziehbar bleibt. Genau dafür braucht es eine schlanke Freigabeakte. Sie muss kein umfangreiches Qualitätshandbuch sein. Entscheidend ist, dass ein anderes Teammitglied aus den Unterlagen erkennen kann, welcher Alarm geprüft wurde, welche Referenz gegolten hat, welche Kennzahlen berechnet wurden und welche Einschränkungen weiterhin bestehen.
Mindestinhalt der Alarmkarte
Die Alarmkarte sollte mindestens Alarmname, betroffene Maschine oder Maschinenfamilie, Zielereignis, ausgeschlossene Phasen, führende Referenzquelle und verantwortliche Freigaberolle enthalten. Ergänzen Sie zwei bis drei Positivbeispiele und zwei Gegenbeispiele. Diese knappe Formulierung verhindert, dass dieselbe Meldung in Produktion, Instandhaltung und IT stillschweigend unterschiedlich interpretiert wird.
Sinnvoll ist außerdem eine explizite Feldliste. Dazu gehören Beobachtungszeitraum, verwendeter Zeitraster, führender Zeitstempel, Zähler für echte Ereignisse, bekannte Nicht-Ereignisse, falsch alarmierte Fenster und berechnete Kennzahlen. Wenn Sie mit einem Standardbegriff wie SourceTimestamp, Retain oder Quality arbeiten, notieren Sie zusätzlich, ob dieses Feld tatsächlich in Ihrer Implementierung vorhanden ist oder ob Sie ein projektinternes Ersatzfeld verwenden. So bleibt die Trennung zwischen Standardumfang und konkreter Umsetzung sichtbar.
Version, Geltungsbereich und Ablaufdatum
Jede Freigabe sollte an einen klaren Geltungsbereich gebunden sein. Das betrifft nicht nur die Maschinen-ID, sondern auch Sensorposition, relevante Produktfamilie, Zustandslogik, Schichtmodell und Datenquelle. Sonst wirkt eine bestandene Prüfung breiter, als sie tatsächlich war. Eine Freigabe für Maschine A mit Werkzeugfamilie X ist nicht automatisch eine Freigabe für Maschine B oder für ein neues Produkt mit anderem Geräusch- oder Bewegungsprofil.
Praktisch hilft ein einfaches Ablaufdatum oder ein Re-Test-Auslöser in der Akte. Schreiben Sie zum Beispiel hinein: Freigabe gilt bis zum nächsten Sensorwechsel, bis zur nächsten Logikänderung oder bis zur Aufschaltung einer neuen Produktfamilie. Damit erzeugen Sie keine künstliche Bürokratie, sondern verhindern, dass alte Prüfstände stillschweigend als heutige Tatsache weiterverwendet werden.
Vorläufige Freigabe klar kennzeichnen
Nicht jede Inbetriebnahme erlaubt sofort eine vollständige Stichprobe. Dann ist eine vorläufige Freigabe legitim, wenn sie offen als vorläufig gekennzeichnet wird. Dokumentieren Sie dabei, welche Situationen bereits geprüft wurden, welche noch fehlen und bis wann die fehlenden Fälle nacherfasst werden sollen. Eine unvollständige Stichprobe wird dadurch nicht zu einer endgültigen Aussage, aber zu einer kontrollierten Übergangsentscheidung.
Gerade bei selten auftretenden Störungen ist diese Offenheit wichtiger als eine scheinbar exakte Zahl. Wenn im Beobachtungszeitraum nur wenige echte Ereignisse vorlagen, sagen Sie das ausdrücklich. Verbinden Sie die Freigabe dann mit klaren Nachbedingungen, etwa einer verlängerten Beobachtungsdauer, einer erneuten Prüfung nach Produktwechsel oder einer zusätzlichen Ground-Truth-Runde bei der nächsten geplanten Schicht mit hohem Risiko.
08 / PRAXISWISSEN
Wo Novo AI fachlich passt und wo nicht zu viel versprochen werden sollte
Novo AI passt in diesem Thema vor allem dort, wo Sie Bestandsmaschinen über externe Signale erschließen und belastbare Zustandsverläufe aufbauen wollen. Öffentlich belegt sind bei Novo die externe Sensorik, die Unterscheidung von Maschinenzuständen, der Pilotansatz und die Trennung zwischen Montage, Validierung und späterer Nutzung. Das ist für Fehlalarmprüfungen relevant, weil Sie genau diese saubere Trennung für jede Freigabe brauchen.
Nicht öffentlich belegt ist dagegen eine allgemeine Aussage, dass Novo-Alarmmodelle ohne zusätzliche Projektprüfung nach jeder Änderung automatisch belastbar bleiben oder dass eine bestimmte Fehlalarmquote pauschal erreicht werde. Solche Aussagen sollten Sie bewusst vermeiden. Für eine belastbare Freigabe zählt immer die konkrete Maschine, das konkrete Signal, der konkrete Prozess und die dokumentierte Referenzstichprobe.
Wenn Sie mit Novo in ein Pilotprojekt gehen, sollte die fachliche Reihenfolge deshalb lauten: Eignung der Maschine prüfen, Zustände definieren, Ground Truth für repräsentative Abläufe erheben, Abgleich rechnen, Freigaberegel schriftlich festhalten und erst dann auf weitere Maschinen ausrollen. Genau dadurch wird aus einer interessanten Visualisierung ein betriebsfähiges Alarmsystem.
09 / PRAXISWISSEN
Fazit: Erst freigeben, dann eskalieren
Fehlalarme bei Maschinenüberwachung werden beherrschbar, wenn Sie sie als Abnahmeproblem behandeln und nicht als Stimmung im Shopfloor. Das robuste Minimum besteht aus klarer Alarmdefinition, unabhängiger Ground Truth, sauberem Zeitabgleich, Fehlalarmquote nach dokumentierter Formel und festen Re-Test-Regeln nach Änderungen. Ohne diese Elemente bleibt die Bewertung schwer nachvollziehbar und ändert sich mit jeder Einzelfall-Diskussion.
Der größte praktische Gewinn liegt nicht in einer theoretisch perfekten Kennzahl, sondern in einer gemeinsamen Prüfsprache. Wenn Produktion, Instandhaltung und IT dieselbe Alarmkarte, dieselbe Stichprobe und dieselbe Matching-Regel nutzen, wird jede spätere Änderung billiger und schneller. Genau dafür ist das hier beschriebene Diagnose- und Abnahmeverfahren gedacht.
Wenn Sie bereits Zustandsdaten aus Ihrer Fertigung haben, starten Sie klein: Wählen Sie einen Alarm mit realer Wirkung, definieren Sie den Bewertungsraum, sammeln Sie eine Ground-Truth-Stichprobe über mehrere kritische Situationen und rechnen Sie die Fehlalarmquote einmal sauber durch. Danach wissen Sie mehr als nach mehreren Bauchgefühl-Diskussionen in der Frühbesprechung.
10 / PRAXISWISSEN
Freigabe-Check für Alarmänderungen
Haken Sie ab, was Sie bereits geklärt haben. Die Auswahl bleibt nur während dieses Seitenbesuchs bestehen.
11 / PRAXISWISSEN
Weiterführende Fragen
Nur dann, wenn diese Schicht die relevanten Situationen tatsächlich abdeckt. Für eine belastbare Freigabe sollten normale Produktion, kritische Übergänge und die betroffene Änderung in der Stichprobe enthalten sein. Fehlen wichtige Situationen, ist eine längere Beobachtungsdauer sinnvoller als eine vorschnelle Freigabe.
Nicht zwingend auf allen Maschinen, aber mindestens auf der betroffenen Alarmkette. Wenn Sensorposition, Signalqualität oder Zeitverhalten verändert wurden, berührt das direkt die fachliche Aussage des Alarms. Dann ist ein Re-Test mit Ground Truth auf der betroffenen Maschine oder Zustandsklasse erforderlich.
Dann sollte die Beobachtungsdauer verlängert oder die Stichprobe gezielt um bekannte kritische Situationen ergänzt werden. Eine Freigabe auf Basis sehr weniger Ereignisse kann scheinbar präzise wirken, reagiert aber stark auf einzelne Fehlklassifikationen. Die bessere Entscheidung ist meist, den Testzeitraum zu verlängern und die Freigabe explizit als vorläufig zu kennzeichnen.
So sieht die Umsetzung in der Praxis aus
Vertiefen Sie den konkreten Anwendungsfall, die Messgrundlage und die Grenzen anhand einer veröffentlichten Novo-AI-Fallstudie.