
NOVO AI · PRAXISLEITFADEN 27 MIN. LESEZEIT
Die Entscheidung auf einen Blick
Referenzdaten für Maschinenzustände entstehen nicht dadurch, dass ein Dashboard plausibel aussieht. Sie werden belastbar, wenn Sie vor der Freigabe schriftlich festlegen, welche Zustände gelten, woraus das führende Label stammt, wie Stichproben geprüft werden und was bei Konflikten, fehlenden Labels oder Änderungen passiert. Genau dieses Protokoll baut der Beitrag auf.
Der Leitfaden ist bewusst vendor-neutral angelegt. Er stützt sich auf die Zustandslogik aus OPC UA for Machinery und deren Verwendung in OPC UA for Machine Tools, auf den methodischen Ground-Truth-Rahmen von NIST sowie auf Anforderungen an Nachvollziehbarkeit und Datenqualität aus der BSI-Übersicht zu KI. Er ist ein dokumentationsbasierter Arbeitsstandard, kein eigener Praxistest.
Wichtig ist die Abgrenzung zu benachbarten Aufgaben. Für die detaillierte operative Bewertung von Alarmrauschen lohnt der Beitrag zu Fehlalarmen bei Maschinenüberwachung. Für die technische Freigabe eines Retrofit-Datenstroms ist das MDE Abnahmeprotokoll für Bestandsmaschinen die passendere Vertiefung. Hier geht es enger um die Frage, wie Sie eine belastbare Referenz für Zustände aufbauen, damit diese später als Prüfmaßstab für KI-Auswertungen dienen kann.
Novo AI veröffentlicht diesen Leitfaden und ist selbst Anbieter einer Lösung zur Zustandsdatenerfassung. Produktbezüge sind deshalb auf öffentlich belegte Aussagen begrenzt. Wo eine Maschine bereits verlässliche native Zustands- oder Monitoringinformationen liefert, sollten diese Quellen in der Referenzstrategie ausdrücklich geprüft werden. Wo das nicht der Fall ist, kann ein Pilot mit externer Erfassung sinnvoll sein, wie die Lösungsseite zur Maschinendatenerfassung für Bestandsmaschinen beschreibt.
01 / PRAXISWISSEN
Was als Referenzdaten zählt – und was nicht
Referenzdaten sind nicht einfach „die Daten, denen das Team vertraut“. Gemeint ist eine kontrolliert erzeugte, nachvollziehbare Beurteilungsgrundlage, mit der Sie prüfen können, ob ein Modell, eine Alarmregel oder eine automatische Zustandserkennung reale Maschinenzustände korrekt abbildet. Das kann direkte Beobachtung sein, nativ bereitgestellte Maschinenzustandsinformation, ein separater Zeitverlauf aus externer Sensorik oder eine begründete Kombination daraus.
Entscheidend ist, dass Sie die Referenz als eigenes Artefakt behandeln. Sie hat einen Geltungsbereich, eine Version, Rollen, Prüfregeln und bekannte Grenzen. Genau hier ist der Hinweis von NIST wichtig: Ground Truth ist ein eigenes Problemfeld, und es gibt keine solide universelle Lösung für alle Anwendungen. Für Brownfield-Projekte folgt daraus keine Resignation, sondern die Pflicht zu einem lokalen, transparenten Verfahren.
Referenzdaten ersetzen auch keine saubere Fachsprache. Wenn Produktion, Instandhaltung und IT mit „Störung“, „Stillstand“, „wartet“ oder „nicht verfügbar“ jeweils andere Dinge meinen, entsteht kein Ground Truth, sondern eine Sammlung von Einzelfallmeinungen. Die Zustandslogik muss daher vor jeder Stichprobe stehen. Das passt zu den Anforderungen des BSI, das Datenqualität, Prüfbarkeit und Nachvollziehbarkeit als zentrale Voraussetzungen für belastbare KI-Nutzung einordnet.
- Referenzdaten sind eine bewusst definierte Prüfbasis.
- Produktionsdaten sind die laufenden Betriebsdaten, die Sie auswerten wollen.
- Labelregeln beschreiben, wie ein Zeitabschnitt einer Klasse zugeordnet wird.
- Freigabe ist die betriebliche Entscheidung, wofür die Daten oder Modelle genutzt werden dürfen.
Für die Praxis ist noch eine Trennung wichtig: Ein korrekt erkannter Zustand erklärt nicht automatisch seine Ursache. Die Novo-Seite zur Maschinendatenerfassung für Bestandsmaschinen benennt diese Grenze ausdrücklich. Dort wird beschrieben, dass erkannte Stillstandsphasen für belastbare Stillstandsgründe durch Bedienerrückmeldungen, Maschinenmeldungen oder weitere Daten ergänzt werden müssen. Genau deshalb darf Ihr Referenzprotokoll Zustandslabel und Ursachencode nicht vermischen.
Ebenso wichtig ist die Trennung zwischen Prüfbasis und späterer Nutzung. Ein Referenzdatensatz kann für die Freigabe einer Zustandsklassifikation ausreichen, ohne schon für OEE, Ursachenparetos oder automatische Maßnahmen zu genügen. Die gelesenen Quellen belegen gerade keine Universallogik, die jede Folgefrage automatisch mitlöst. Deshalb sollte Ihre Freigabeakte immer ausdrücklich benennen, wofür die Referenz gilt und wofür noch nicht.
02 / PRAXISWISSEN
Das Referenzdaten-Protokoll für Maschinenzustände
Wenn Sie nur einen Abschnitt übernehmen, dann diesen. Das Protokoll bündelt die Mindestfestlegungen, die vor jeder Freigabe von Zustandsmodellen, Alarmregeln oder KI-Auswertungen vorliegen sollten. Es ist keine Norm und keine universelle Schablone. Es ist eine empfohlene Arbeitsvorlage, mit der Produktion, OT, Instandhaltung und Digitalisierungsverantwortliche dieselbe Prüflogik verwenden können.
Pflichtbausteine des Referenzdaten-Protokolls
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Was schriftlich festgelegt wird
Top-Level-Zustände, lokale Unterzustände, ausgeschlossene Phasen und BegriffsdefinitionenWoran die Festlegung geprüft wird
Grenzfälle führen bei allen Beteiligten zur gleichen KlassifikationWas schriftlich festgelegt wird
Welche Quelle pro Zeitraum das Primärlabel liefert und welche Gegenquelle zur Plausibilisierung dientWoran die Festlegung geprüft wird
Das zu prüfende Modell validiert nicht nur seine eigene DatenbasisWas schriftlich festgelegt wird
Start- und Endkriterium, Mindestdauer, Umgang mit Wechseln, Klasse „Unbekannt“ und erlaubte EvidenzenWoran die Festlegung geprüft wird
Ein fremdes Teammitglied kann dieselbe Probe mit denselben Regeln nachlabelnWas schriftlich festgelegt wird
Zeiträume, Schichten, Produktvarianten, Sonderfälle und bestätigte Nicht-Ereignis-FensterWoran die Festlegung geprüft wird
Normale und kritische Situationen sind beide im Prüfset vertretenWas schriftlich festgelegt wird
Wer doppelt labelt, wer entscheidet, wie Änderungen dokumentiert werden und wann ein Label gesperrt bleibtWoran die Festlegung geprüft wird
Jede Änderung ist versionsfähig und begründetWas schriftlich festgelegt wird
Welche Änderungen eine neue Freigaberunde auslösen und welche Teile des Prüfsets wiederholt werdenWoran die Festlegung geprüft wird
Nach Sensor-, Modell- oder Prozessänderung bleibt die Vergleichbarkeit erhaltenDas Protokoll sollte nicht erst nach dem Pilot entstehen. Wenn die Regeln erst nach den ersten Diskussionen formuliert werden, passen sie sich unbemerkt an die Streitfälle an. Besser ist die umgekehrte Reihenfolge: zuerst Begriffe, Rollen und Prüffragen einfrieren, dann labeln, dann auswerten. Für die nachgelagerte Freigabe von Alarmen oder KPIs haben Sie damit ein belastbares Fundament statt eines rückwirkend erklärten Ergebnisses.
Zur Protokollführung gehören außerdem ein paar nüchterne Verwaltungsangaben, die im Alltag gerne fehlen: Geltungsbereich, Maschinenliste, Version, Verantwortliche, Datum der Freigabe und Anlass der letzten Änderung. Diese Angaben sind keine Bürokratie um ihrer selbst willen. Sie verhindern, dass Monate später unklar bleibt, ob eine Freigabe für eine einzelne Pilotmaschine, eine Produktfamilie oder schon für einen ganzen Bereich gemeint war.
Für die Praxis hat sich eine einfache Struktur bewährt: Deckblatt mit Geltungsbereich, dann Zustandsmodell, Quellenlogik, Stichprobenplan, Konfliktliste und Re-Test-Regeln. Mehr braucht eine erste Freigabeakte nicht. Entscheidend ist, dass jede Person im Review dieselbe Datei prüft und nicht zwischen Präsentation, Chat-Verlauf und einzelnen Exporten zusammensuchen muss, was eigentlich als geltende Referenz beschlossen wurde.
Für den Start reichen sechs Arbeitsschritte. Sie können sie in einer Freigabeakte oder in einem kurzen Datenvertrag dokumentieren. Entscheidend ist nicht die Länge, sondern die Reproduzierbarkeit. Eine Seite mit klaren Regeln ist nützlicher als zwanzig Seiten Projektprosa, die keine einzige Grenzfrage eindeutig entscheidet.
- Zustandslogik einfrieren: Top-Level-Zustände, Unterzustände und Ausschlüsse festlegen.
- Referenzquelle bestimmen: pro Zeitraum eine führende Quelle und mindestens eine Gegenquelle benennen.
- Labelregeln schreiben: Zeitbezug, Mindestdauer, Evidenzen und „Unbekannt“-Regel definieren.
- Stichprobe planen: normale Produktion, Rüst- und Randfälle, Neustart, Stillstand und Nicht-Ereignis-Fenster auswählen.
- Doppellabeln und eskalieren: Konflikte nicht überstimmen, sondern nach festem Weg prüfen.
- Re-Test auslösen: Änderungen an Sensorik, Modell, Produktmix oder Kalender schriftlich an eine neue Prüfrunde koppeln.
Wenn Sie dieses Protokoll sauber führen, können Sie spätere Spezialfragen gezielt auslagern. Dann verweisen Sie für tiefergehende Alarmmetriken auf den Beitrag zu Fehlalarmen bei Maschinenüberwachung und für die technische Datenfreigabe auf das MDE Abnahmeprotokoll, ohne die Grundlogik Ihrer Referenzdaten erneut verhandeln zu müssen.
03 / PRAXISWISSEN
Referenzdaten für Maschinenzustände: Zustandsklassen zuerst sauber schneiden
Für Brownfield-Projekte ist die Zustandslogik der wichtigste fachliche Hebel. OPC UA for Machinery definiert vier Top-Level-Zustände für ein MachineryItem: NotAvailable, OutOfService, NotExecuting und Executing. Die Spezifikation erlaubt Unterzustände, aber keine zusätzlichen Top-Level-Zustände. Genau diese Disziplin eignet sich als gemeinsame Sprache für Referenzdaten, weil sie technische und organisatorische Nicht-Produktion trennt.
Wichtig ist die Trennung zwischen Standardumfang und tatsächlicher Implementierung. Dass die Spezifikation diese vier Zustände vorsieht, belegt noch nicht, dass Ihre konkrete Maschine, Ihr Server oder Ihr Client sie vollständig und sauber bereitstellt. Wenn eine Anlage die standardisierte Zustandsmaschine nicht exponiert, folgt daraus nicht, dass der Standard falsch wäre. Es folgt nur, dass Sie die lokale Zustandslogik selbst dokumentieren und die Abweichung zwischen Standardbegriff und tatsächlicher Datenquelle offenlegen müssen.
Für Workshops mit Produktion und Instandhaltung ist es hilfreich, lokale Werksbegriffe zuerst zu sammeln und erst danach sauber auf die Top-Level-Ebene zu mappen. So sehen Sie früh, welche Wörter nur Synonyme sind und welche Begriffe eigentlich unterschiedliche Zustände meinen. Genau diese Mappung gehört in die Freigabeakte. Sonst spricht das Team im Review über „Warten“ oder „Störung“, meint aber je nach Rolle unterschiedliche Ereignisse.
Vier Top-Level-Zustände als gemeinsame Sprache
Die vier Zustände sind kein komplettes OEE-Regelwerk und auch kein fertiger Grundkatalog. Sie bilden eine obere Hierarchie, auf die sich lokale Regeln abstützen können. Für Referenzdaten ist das hilfreich, weil Sie erst auf dieser Ebene Konsens schaffen und erst danach lokale Unterteilungen wie Rüsten, Materialwarten, Wartung oder Energiepause ergänzen. Damit trennen Sie stabile Oberklassen von späteren Werkdetails.
Empfohlene Übersetzung der Top-Level-Zustände in eine lokale Werksregel
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Lokale Leitfrage
Verfolgt die Maschine aktuell ihren Zweck?Was dazugehört
Produzieren, Bearbeiten, Transportieren oder ein definierter aktiver ProzessWas bewusst getrennt bleiben sollte
Gutmenge, Qualität und UrsachenbuchungLokale Leitfrage
Ist die Maschine funktionsfähig, wartet aber auf einen externen Anlass?Was dazugehört
Warten auf Auftrag, Material, Freigabe, Bedienhandlung oder StartsignalWas bewusst getrennt bleiben sollte
Technische Störung im Inneren der MaschineLokale Leitfrage
Ist die Maschine verfügbar, aber aus technischem Grund nicht arbeitsfähig?Was dazugehört
Fehlerzustand, Reparatur, technische Wartung, Reinigung aus technischem AnlassWas bewusst getrennt bleiben sollte
Organisatorisches Warten und geplante NichtnutzungLokale Leitfrage
Ist die Maschine als Objekt nicht verfügbar?Was dazugehört
Abgeschaltet, energiereduziert oder definierte NichtverfügbarkeitWas bewusst getrennt bleiben sollte
Verbindungsverlust des Servers ohne bekannten MaschinenzustandGerade der letzte Punkt ist wichtig. Die OPC-Spezifikation weist ausdrücklich darauf hin, dass NotAvailable nur verwendet werden sollte, wenn der Maschinenzustand bekannt ist. Geht lediglich die Verbindung verloren, ist das nicht automatisch ein sicherer Maschinenzustand, sondern zunächst ein Qualitäts- oder Kommunikationsproblem. Für Referenzdaten heißt das: Eine Datenlücke ist nicht stillschweigend ein echter Stopp und auch nicht stillschweigend Nichtverfügbarkeit.
Für die lokale Übersetzung lohnt sich eine kleine Prüffrage pro Oberklasse. Sie hilft, unpräzise Sammelwörter im Team zu vermeiden. Wenn ein Begriff nicht durch eine eindeutige Leitfrage abgesichert werden kann, ist er als Top-Level-Begriff zu unscharf. Dann sollte er als Unterzustand, Freitext oder Kontextmerkmal geführt werden, nicht als tragende Klasse der Referenz.
Technischer Stopp ist nicht organisatorisches Warten
Die wichtigste Trennlinie verläuft zwischen OutOfService und NotExecuting. Laut OPC UA for Machinery steht OutOfService für einen technischen Grund aus der Maschine heraus. NotExecuting beschreibt dagegen einen funktionsfähigen Zustand ohne Aktivität, ausgelöst durch einen organisatorischen Grund von außen. Für eine belastbare Referenz ist diese Trennung zentral, weil sie spätere Ursachenanalysen und Fehlalarmprüfungen direkt beeinflusst.
Praktisch heißt das: „Maschine steht“ ist als Label zu grob. Wenn das Team im selben Topf Materialwarten, fehlende Freigabe und technische Störung sammelt, kann kein Modell später sauber lernen, und keine Alarmquote wird sinnvoll interpretierbar. Ein vermeintlicher Fehlalarm kann dann schlicht daraus entstehen, dass das Prüfsystem externes Warten als technischen Fehler bewertet oder umgekehrt.
Für die Diskussion mit operativen Teams hilft eine einfache Gegenfrage: Würde die Maschine ohne Eingriff von außen ihren Zweck aktuell wieder verfolgen können? Wenn ja, spricht das eher für NotExecuting. Wenn nein und die Ursache im Inneren der Maschine liegt, spricht das eher für OutOfService. Diese Regel ist keine normative Pflichtformel, sondern eine abgeleitete Prüfhilfe aus der dokumentierten Zustandssemantik.
Auch lokale Begriffe wie „Einrichter dran“, „Warten auf Teile“ oder „Störung noch nicht quittiert“ sollten Sie an dieser Trennlinie prüfen. Die Alltagssprache kann in der Freigabeakte erhalten bleiben, solange klar dokumentiert ist, unter welcher Oberklasse sie geführt wird. Genau diese zweistufige Logik macht spätere Re-Tests stabiler, weil lokale Wortwahl sich ändern kann, die Top-Level-Semantik aber gleich bleibt.
Unterzustände lokal ergänzen, Top-Level stabil halten
Die Spezifikation erlaubt Unterzustände, und genau das brauchen Sie im Werk. Rüsten, Material fehlt, Instandhaltung vor Ort, Störung quittiert aber noch nicht behoben, Reinigung, Energiepause oder Warmlauf sind betriebliche Informationen, die auf Top-Level-Ebene allein nicht reichen. Entscheidend ist nur, dass diese Unterzustände sauber unter einer stabilen Oberklasse hängen und nicht je Schicht auf wechselnde Oberbegriffe gehoben werden.
Ich empfehle, Unterzustände nur dann neu aufzunehmen, wenn daraus entweder eine klare operative Maßnahme oder eine klare Freigabefrage folgt. Jede zusätzliche Klasse erhöht Labelaufwand, Konfliktrisiko und Re-Test-Bedarf. Für die frühe Freigabe kann deshalb ein konservatives Modell sinnvoll sein: wenige stabile Oberklassen, dazu ein begrenzter Satz lokal relevanter Unterzustände mit eindeutigen Start- und Endregeln.
Ein guter Grenztest lautet: Würde dieselbe zusätzliche Klasse bei einer späteren Review-Runde wirklich zu einer anderen Handlung führen? Wenn nicht, erzeugt sie meist nur mehr Diskussion im Labelprozess. Dann ist es sauberer, die Information als Kommentar, Kontextmerkmal oder spätere Ursachenebene zu führen. Referenzdaten sollen Unterschiede sichtbar machen, nicht jede Werkrealität gleichzeitig vollständig abbilden.
Wenn Sie noch ganz am Anfang stehen und zunächst nur prüfen wollen, ob Zustände überhaupt reproduzierbar unterscheidbar sind, hilft der Beitrag Maschinenzustände automatisch erkennen als vorgelagerte Einordnung. Für Referenzdaten gilt danach aber ein strengerer Maßstab: Was im Pilot plausibel aussieht, muss für die Freigabe wiederholbar und kontrolliert labelbar sein.
04 / PRAXISWISSEN
Ground Truth im Brownfield gewinnen
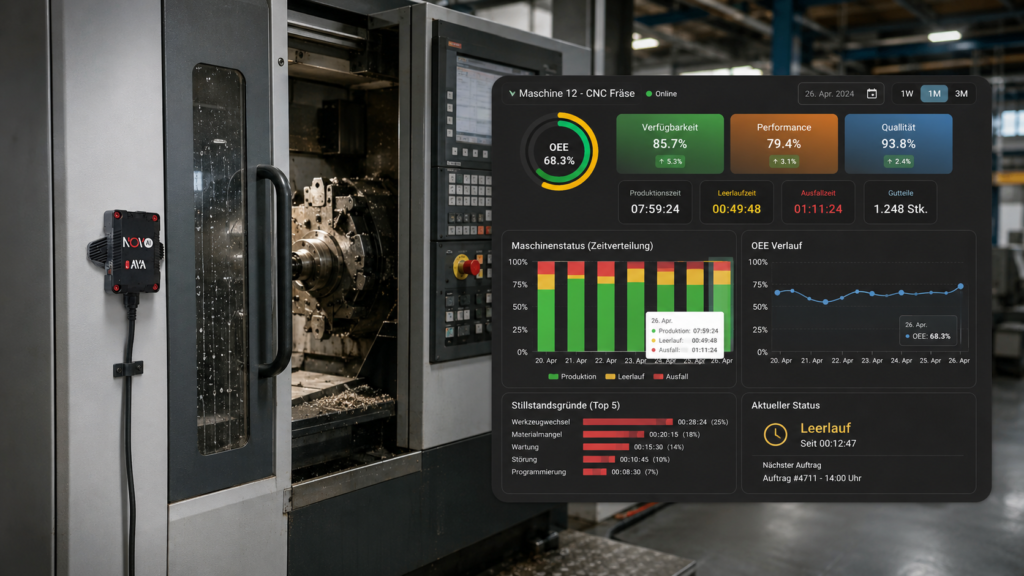
NIST nennt mehrere Wege zur Ground-Truth-Gewinnung, darunter annotation/labeling, physically sensed, platform-based und weitere Systeme. Der wichtige Schluss für Bestandsmaschinen ist nicht, dass Sie eine perfekte Standardlösung auswählen müssten. Der wichtigere Schluss lautet: Sie sollten die Quelle Ihrer Referenz bewusst wählen und offenlegen, statt sie implizit aus dem Zielsystem abzuleiten.
Für Brownfield-Projekte ist dabei Zurückhaltung oft nützlicher als Vollständigkeitsanspruch. Eine kleine, klar dokumentierte Quellenkombination lässt sich sauber prüfen. Ein überfrachteter Ansatz mit vielen Datenkanälen erzeugt dagegen schnell unklare Prioritäten. Dann wissen Teams zwar, dass mehrere Artefakte existieren, aber nicht mehr, welche Evidenz im Streitfall wirklich das Primärlabel tragen soll.
Führende Quelle und Gegenquelle festlegen
Ein belastbares Referenzlabel braucht eine führende Quelle. Das kann bei einer Maschine mit guter nativer Schnittstelle eine bereitgestellte Maschinenzustandsinformation aus einer Monitoring-Schnittstelle sein. Bei einem nachgerüsteten Brownfield-Setup kann es eine direkte Beobachtung mit Zeitprotokoll sein. Bei strittigen Abschnitten kann auch eine Kombination aus Beobachtung, Maschinenzustandsinformation und separatem Verlauf nötig sein. Entscheidend ist, dass Sie pro Zeitraum wissen, welche Quelle Vorrang hat und warum.
Zusätzlich sollten Sie eine Gegenquelle definieren. Sie muss kein vollständiges Parallelmodell sein. Schon eine zweite, anders entstandene Sicht auf denselben Zeitabschnitt kann genügen: Beobachtung gegen Schnittstellenzustand, Schnittstellenzustand gegen separates Signal oder Bedienprotokoll gegen Zustandsband. Ohne Gegenquelle sehen Fehler lange wie Konsistenz aus, weil dasselbe System seine eigenen Annahmen bestätigt.
Wenn eine Monitoring-Schnittstelle laut Standard Maschinenzustandsinformation tragen kann, ist das ein wertvoller Ausgangspunkt, aber noch kein Implementierungsnachweis. Prüfen Sie deshalb lokal, ob Ihre konkrete Maschine diese Information wirklich liefert, wie der Zeitbezug gesetzt wird und ob alle für Sie relevanten Betriebsphasen enthalten sind. Erst danach können Sie entscheiden, ob diese Quelle führend, ergänzend oder nur für einzelne Zeiträume nutzbar ist.
Wenn kein nutzbarer SPS-Zugriff vorliegt, kann eine externe Zustandserfassung pragmatisch sein. Die Novo-Seite zur Maschinendatenerfassung für Bestandsmaschinen beschreibt, dass Akustik- und Schwingungssignale Maschinenzustände unterscheiden helfen und in Zeitverläufe überführt werden. Die gleiche Seite grenzt aber ebenso klar ein, dass erkannte Stillstandsphasen ihre Ursachen noch nicht selbst erklären. Diese Trennung sollten Sie im Referenzprotokoll konsequent übernehmen.
Dokumentationsvergleich der Referenzquellen, kein Praxistest
Die folgende Tabelle vergleicht nicht Anbieter, sondern öffentlich belegte Eigenschaften möglicher Referenzquellen im gelesenen Material. „Nicht öffentlich belegt“ bedeutet hier ausdrücklich nicht „ungeeignet“, sondern nur: Im vorliegenden Quellenmaterial ist dieser Punkt nicht direkt nachgewiesen. Der NIST-Bezug stammt aus einem am 29. März 2013 veröffentlichten Überblick. Für die gelesene OPC-UA-Seite, die gelesene BSI-Übersicht und die gelesene Novo-Seite ist ein Veröffentlichungsdatum in den vorliegenden Angaben nicht belegt.
Referenzquellen für Maschinenzustände kombinieren, nicht verwechseln
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Direkte Beobachtung / Annotation
NIST nennt Annotation/Labeling ausdrücklich als Ground-Truth-Systemtyp.Maschinenzustandsinformation aus Monitoring-Schnittstelle
OPC UA for Machine Tools beschreibt, dass Maschinenzustandsinformation in der Monitoring-Schnittstelle verfügbar ist.Externer Sensorverlauf
Die Novo-Dokumentation beschreibt externe Sensorik und daraus abgeleitete Zustands- und Zeitverläufe.Bedien- / Schichtprotokoll
Als eigener Ground-Truth-Systemtyp oder standardisierte Zustandsquelle im gelesenen Material nicht ausdrücklich beschrieben.Direkte Beobachtung / Annotation
NIST beschreibt Ground-Truth-Systeme und unterschiedliche physische Größen als Methodenrahmen.Maschinenzustandsinformation aus Monitoring-Schnittstelle
Die Schnittstelle stellt Maschinenzustandsinformation bereit; der konkrete Implementierungsumfang Ihrer Maschine muss lokal geprüft werden.Externer Sensorverlauf
Die Novo-Seite nennt Akustik- und Schwingungssignale als Grundlage der Auswertung.Bedien- / Schichtprotokoll
Eine öffentliche Mindestbeschreibung für Signale oder strukturierte Evidenz ist im gelesenen Material nicht belegt.Direkte Beobachtung / Annotation
Im gelesenen Material nicht ausdrücklich belegt.Maschinenzustandsinformation aus Monitoring-Schnittstelle
Im gelesenen Material nicht ausdrücklich belegt.Externer Sensorverlauf
Ja. Die Novo-Dokumentation trennt Zustandserkennung und Ursachenklärung ausdrücklich.Bedien- / Schichtprotokoll
Im gelesenen Material nicht ausdrücklich belegt.Direkte Beobachtung / Annotation
Nein. NIST verneint eine solide universelle Lösung für Ground Truth.Maschinenzustandsinformation aus Monitoring-Schnittstelle
Im gelesenen Material nicht als Universallösung belegt.Externer Sensorverlauf
Im gelesenen Material nicht als Universallösung belegt.Bedien- / Schichtprotokoll
Im gelesenen Material nicht als Universallösung belegt.Für die Werkspraxis folgt daraus eine nüchterne Empfehlung: Verwenden Sie lieber eine kleine, klar begründete Quellenkombination als eine angeblich vollständige Einheitswahrheit. Eine plausible Kombination ist etwa direkte Beobachtung als führende Quelle für Grenzfälle, nativ bereitgestellte Maschinenzustandsinformation als Gegenquelle und ein Schichtprotokoll nur als ergänzende Kontextquelle. Welche Kombination passt, hängt an Ihrer Anlage, nicht an einer allgemeinen Rangliste.
Rollen, Zeitstempel und Beweismittel
Damit aus einzelnen Quellen wirklich Referenzdaten werden, müssen Rollen und Nachweise stimmen. Legen Sie mindestens vier Rollen fest: fachlicher Owner des Zustandsmodells, Labeler A, Labeler B und Eskalationsentscheider. Bei kleinen Teams können Personen mehrere Rollen tragen, solange Erstlabel und Konfliktentscheidung nicht vollständig zusammenfallen. Für die Prüfbarkeit ist diese organisatorische Trennung nützlicher als zusätzliche Statistik, wenn sonst Herkunft und Entscheidung eines Labels nicht mehr nachvollziehbar bleiben.
Jedes Label braucht einen nachvollziehbaren Zeitbezug. Ein Intervall ohne Start- und Endlogik ist nur eine Meinung. Dokumentieren Sie deshalb immer, auf welcher Uhr und in welchem Raster gelabelt wird. Für die anschließende technische Prüfung von Zeitbasis, Uhrkonsistenz und Datenlücken sollten Sie das MDE Abnahmeprotokoll für Bestandsmaschinen parallel verwenden, weil dort genau diese Ebene getrennt betrachtet wird.
Als Mindestsatz können drei Artefakte genügen: ein exportierbarer Verlauf, ein kurzes Beobachtungsprotokoll und eine eindeutige Fallnummer. Zusätzliche Artefakte wie Maschinenmeldungen, Zählerstände oder Kommentare kommen nur dann hinzu, wenn sie den Streitfall tatsächlich entscheiden. Mehr Dokumente machen ein Label nicht automatisch besser. Besser wird es, wenn die entscheidende Evidenz pro Fall sofort erkennbar bleibt.
Für jede Probe sollte in der Akte deshalb eine kleine Evidenzkarte stehen: Zeitfenster, führende Quelle, Gegenquelle, verantwortliche Rollen, Endlabel und offener Klärungsbedarf. Diese Mini-Struktur ist im Review sehr wirksam. Sie verhindert, dass Diskussionen über Labels von Fall zu Fall anders geführt werden oder wichtige Randbedingungen erst im Nachhinein aus Erinnerungen ergänzt werden.
05 / PRAXISWISSEN
Stichprobenplan und Mindestprüfungen für Fehlalarme
Eine Referenzprüfung wird schnell wertlos, wenn die Stichprobe nur bequeme Produktionsphasen enthält oder wenn bestätigte Nicht-Ereignisse fehlen. Genau deshalb sollten Sie den Stichprobenplan vor der ersten Gütediskussion einfrieren. Für die spätere detaillierte Bewertung von Fehlalarmquoten und Zusatzmetriken können Sie anschließend gezielt auf den Beitrag zu Fehlalarmen bei Maschinenüberwachung aufbauen.
Bewertungsraum vorher einfrieren
Der Bewertungsraum beantwortet die Frage, welche Zeitabschnitte überhaupt in die Referenzprüfung eingehen. Ohne diese Festlegung wird die Freigabe beliebig. Wenn Pausen, geplante Reinigung, manuelle Einrichtphasen oder Kommunikationsausfälle mal mitlaufen und mal ausgeschlossen werden, ist jede Quote zwar rechnerisch sauber, fachlich aber wertlos. Der Bewertungsraum gehört daher schriftlich in Ihr Protokoll.
Für Zustandsreferenzen empfehle ich, den Raum pro Use Case zu definieren. Prüfen Sie zum Beispiel eine automatische Erkennung von Produktion gegen Warten und technische Störung, dann müssen geplante Nicht-Nutzungsphasen separat markiert sein. Prüfen Sie dagegen ein breiteres OEE-nahes Zustandsmodell, brauchen Sie zusätzlich eine klare Kalender- und Ausschlusslogik. Genau an dieser Grenze treffen Referenzdaten und Abnahmeprotokoll aufeinander.
Hilfreich ist ein einfacher Satz je Freigabezweck: „Diese Referenz gilt für Zeitraum X, Maschinen Y, die dokumentierten Ausschlüsse Z und die Zustandsfrage A.“ Damit wird sichtbar, ob sich zwei scheinbar ähnliche Freigaben überhaupt auf denselben Bewertungsraum beziehen. Ohne diese Präzisierung werden Konflikte aus unterschiedlichen Geltungsbereichen leicht als Qualitätsproblem des Modells missverstanden.
Doppellabeln statt Einzelurteil
Eine einzelne Person sollte kritische Stichproben nicht allein labeln. Selbst wenn diese Person die Anlage am besten kennt, bleibt unklar, ob das Ergebnis reproduzierbar ist. Besser ist ein Doppellabeln repräsentativer Ausschnitte: zwei Personen labeln unabhängig voneinander denselben Zeitraum nach derselben Regel. Erst danach werden Abweichungen verglichen. So trennen Sie Regelunschärfe von bloßem Erinnerungswissen.
Doppellabeln muss nicht über das gesamte Dataset gehen. Sie können den Doppellabel-Umfang auf konfliktsensitive Bereiche konzentrieren: Zustandsgrenzen, kurze Unterbrechungen, Neustarts, Produktwechsel, Einrichtphasen und Abschnitte mit schwacher Evidenz. Dort prüfen Sie das Regelwerk am schärfsten. Wenn Sie priorisieren müssen, stehen diese Bereiche fachlich vor ruhiger Serienproduktion ohne Kontextwechsel.
Für die Durchführung genügt oft eine einfache Arbeitsregel: Erst unabhängig labeln, dann Abweichungen nebeneinander legen, dann Regel und Evidenz getrennt prüfen. Sobald der Abgleich schon während des Erstlabels stattfindet, verlieren Sie die eigentliche Prüffunktion des Doppellabelns. Dann wird aus zwei unabhängigen Perspektiven nur noch ein früh harmonisiertes Teamurteil.
Nicht-Ereignis-Fenster bewusst auswählen
Bestätigte Nicht-Ereignis-Fenster sind kein Nebenprodukt. Sie müssen gezielt in den Stichprobenplan aufgenommen werden. Sonst prüfen Sie nur, ob ein System echte Ereignisse erkennt, nicht aber, ob es außerhalb dieser Ereignisse unnötiges Rauschen erzeugt. Für Alarm- oder Ereignisfreigaben ist das eine zentrale Lücke, weil gerade die ruhigen Phasen zeigen, wie stabil eine Zustandslogik unter normalen Bedingungen bleibt.
Praktisch bedeutet das: Halten Sie im Prüfset ausdrücklich Zeitfenster fest, in denen das Zielereignis nicht vorliegen soll. Diese Fenster sollten genauso dokumentiert werden wie echte Ereignisse: Zeitraum, Maschine, Schicht, Begründung und Gegenquelle. Erst dann können Sie spätere Fehlalarme nachvollziehbar zählen. Ein bloßes „Da war wohl nichts“ genügt für eine belastbare Referenz nicht.
Mindestprüfungen ohne erfundene Schwelle
Die gelesenen Quellen liefern keine universelle Freigabeschwelle, ab der Referenzdaten „gut genug“ wären. Genau deshalb sollte Ihr Protokoll keine künstlichen Grenzwerte erfinden. Stattdessen empfehle ich Mindestprüfungen, die unabhängig von einer festen Quote fachlich notwendig sind: Labelabdeckung, Konfliktliste, dokumentierte Nicht-Ereignis-Fenster, Zeitabgleich und Re-Test-Regeln. Aus diesen Prüfungen entsteht dann eine betriebliche Freigabeentscheidung.
- Labelabdeckung prüfen: Wie viel des Bewertungsraums ist eindeutig gelabelt, wie viel bleibt bewusst unbekannt?
- Konfliktfälle einzeln prüfen: Welche Regeln erzeugen wiederholt Uneinigkeit, und welche Evidenz entscheidet dort?
- Nicht-Ereignis-Fenster sichern: Ohne bestätigte Nicht-Ereignisse können Sie Fehlalarme nicht belastbar bewerten.
- Zeitbezug abgleichen: Referenz und Zielsystem müssen auf denselben oder dokumentiert übersetzten Zeitbezug gemappt werden.
- Änderungen markieren: Jede Sensor-, Modell- oder Prozessänderung muss später gezielt in den Re-Test zurückfließen.
Diese Mindestprüfungen sind klein genug für eine Freigabeakte und streng genug für belastbare Entscheidungen. Sie verhindern, dass eine Freigabe aus einem einzigen guten Beispiel abgeleitet wird. Und sie verhindern die Gegenbewegung ebenso: dass ein einzelner Grenzfall ein grundsätzlich brauchbares Modell komplett blockiert, obwohl die eigentliche Ursache im Zeitbezug oder in einer unklaren Labelregel liegt.
Wenn Ihre Stichprobe zwar gute Labels hat, aber der Datenstrom selbst an Zeitstempeln, Reihenfolge oder Wiederanlauf leidet, sollten Sie die Freigabe nicht mit zusätzlichem Nachlabeln retten. In solchen Fällen muss zuerst die technische Basis geklärt werden. Dafür ist der Beitrag zu MDE Abnahmeprotokoll die richtige Ergänzung. Referenzdaten ersetzen keine fehlerhafte Zeitachse.
06 / PRAXISWISSEN
Wenn Labels fehlen oder kollidieren
Fehlende oder widersprüchliche Labels müssen im Protokoll ausdrücklich vorgesehen sein. Der Fehler liegt nicht darin, dass Unklarheit auftaucht. Der Fehler beginnt erst, wenn diese Unklarheit stillschweigend geglättet wird. Genau deshalb sollte Ihr Protokoll einen offiziellen Status für „Unbekannt“ oder „nicht freigegeben“ enthalten, statt jedes Fenster mit Gewalt in eine Fachklasse zu drücken.
Unbekannt ist eine gültige Klasse
Ein unbekanntes Label ist kein Makel, sondern eine saubere Aussage über die Grenzen Ihrer Evidenz. Es zeigt, dass die Maschine, der Zeitbezug oder die Beobachtung in diesem Intervall keine belastbare Zuordnung zulassen. Für Freigaben ist das viel nützlicher als ein geratenes Label, das später als scheinbar harte Wahrheit in Alarmprüfungen oder Modellmetriken weiterlebt.
Ich empfehle, „Unbekannt“ nur unter klaren Bedingungen zuzulassen: widersprüchliche Evidenz, fehlende führende Quelle, nicht auflösbare Zeitdifferenz oder definierter Grenzfall ohne ausreichende Beweismittel. Nicht zulässig sollte „Unbekannt“ als bequemer Sammelplatz für fehlende Disziplin sein. Wenn sich Unbekannt-Fälle häufen, ist das ein Signal für eine Regel- oder Datenlücke, nicht für mehr Toleranz im Review.
Für die Freigabepraxis hilft eine zusätzliche Markierung: unbekannt wegen Regelkonflikt, unbekannt wegen Evidenzlücke oder unbekannt wegen Zeitproblem. So bleibt sichtbar, an welcher Stelle der Nachbesserungsbedarf liegt. Ohne diese zweite Ebene sammeln Sie zwar Unbekannt-Fälle, lernen aus ihnen aber deutlich weniger für die nächste Labelrunde.
Eskalationsweg für Konflikte
Konflikte zwischen zwei Labelern sollten nicht in informellen Gesprächen verschwinden. Legen Sie einen festen Eskalationsweg fest: erst Vergleich der verwendeten Regel, dann Vergleich der Evidenz, dann Entscheidung durch den fachlichen Owner oder ein kleines Review-Gremium. Wenn die Evidenz nicht reicht, bleibt das Fenster unbekannt oder wird aus diesem Prüfschritt ausgeschlossen. Das ist sauberer als ein Mehrheitslabel ohne Grundlage.
Hilfreich ist außerdem eine Konfliktklassifikation. Nicht jeder Konflikt ist gleich. Trennen Sie mindestens zwischen Regelkonflikt, Zeitkonflikt, Evidenzkonflikt und Rollen- oder Kontextkonflikt. Ein Regelkonflikt verlangt meist eine Nachschärfung der Definition. Ein Zeitkonflikt verweist eher auf Uhr- oder Schnittprobleme. Ein Evidenzkonflikt kann zusätzliche Beweismittel erfordern. Erst diese Trennung macht aus Uneinigkeit eine bearbeitbare Ursache.
Ein kleiner Reviewbogen reicht dafür aus: Fallnummer, strittiger Zeitraum, Erstlabels, verwendete Evidenz, Konfliktart, Entscheidung und Folgeaktion. Diese Dokumentation spart später Zeit, weil sich wiederkehrende Konflikte bündeln lassen. Dann sehen Sie nicht nur, dass Uneinigkeit entstanden ist, sondern auch, ob die Ursache im Regelwerk, im Datenstrom oder in einer unklaren Rollenverteilung liegt.
Nachlabeln versionieren
Nachlabeln ist unvermeidlich, aber nur dann brauchbar, wenn jede Änderung versioniert wird. Speichern Sie deshalb mindestens Labelversion, Änderungsdatum, Anlass, verantwortliche Rolle und ersetzte Evidenz. Ohne diese Historie können Sie später nicht mehr sagen, ob eine bessere Metrik auf ein besseres Modell oder nur auf eine still veränderte Referenz zurückgeht. Gerade bei KI-Auswertungen ist diese Trennung für Vertrauen entscheidend.
Das BSI betont in seiner KI-Übersicht die Bedeutung von Prüfkriterien, Methodologien und Datenqualität für verlässliche Bewertungen. Übersetzt in den Shopfloor heißt das: Ein Label, das sich ändern darf, braucht eine dokumentierte Begründung. Sonst wird Ihre Referenz über Monate schleichend angepasst, bis zwar die Zahlen ruhig aussehen, aber niemand mehr erklären kann, welche Realität sie eigentlich abbilden sollen.
Für den Alltag genügt bereits eine einfache Versionslogik: freigegebene Referenz, in Prüfung befindliche Änderungen und verworfene Änderungsvorschläge. Diese Trennung verhindert, dass Teams versehentlich mit Zwischenständen arbeiten. Gerade bei mehreren Maschinen oder längeren Piloten ist das wichtiger als eine aufwendige Tool-Landschaft. Entscheidend ist nicht das System, sondern die nachvollziehbare Statusführung.
07 / PRAXISWISSEN
Re-Test nach Änderungen
Referenzdaten sind keine einmalige Projektleistung. Sie bleiben nur belastbar, wenn Änderungen sichtbar eine neue Prüfrunde auslösen. Das gilt nicht nur für ein neues Modell, sondern schon für veränderte Sensorpositionen, andere Produktvarianten, geänderte Start-Stopp-Logik, neue Kalenderregeln oder ergänzte Unterzustände. Wer diese Änderungen nicht an einen Re-Test bindet, verwaltet alte Freigaben für neue Wirklichkeiten.
Was eine neue Freigaberunde auslöst
Mindestens vier Änderungsarten sollten schriftlich als Re-Test-Trigger gelten: Änderung an Sensorik oder Montage, Änderung am Auswerte- oder Alarmmodell, Änderung im Prozesskontext und Änderung am Labelregelwerk. Prozesskontext meint hier nicht nur eine neue Maschine. Schon ein neues Produkt mit anderer Geräusch- oder Zykluscharakteristik kann die Aussagekraft einer alten Referenz verschieben.
Auch organisatorische Änderungen zählen. Wenn Schichtkalender, Freigaberollen oder Ausschlussregeln angepasst werden, verändern Sie den Bewertungsraum. Dann ist ein alter Nachweis nicht automatisch falsch, aber seine Geltung ist eingeschränkt. Genau diese Begrenzung muss in die Freigabeakte. „Vorhandene Freigabe weiter nutzen“ ist nur dann legitim, wenn das Protokoll ausdrücklich beschreibt, warum die Änderung den geprüften Zweck nicht berührt.
Hilfreich ist eine kleine Triggerliste mit Ja/Nein-Prüfung: Hat sich die Sensorposition geändert? Wurden neue Produktvarianten aufgenommen? Wurde die Start- oder Endregel für einen Zustand angepasst? Hat sich der Kalenderschnitt geändert? Schon vier bis sechs Fragen reichen aus, um im Alltag sichtbar zu machen, ob ein Re-Test formal ausgelöst werden sollte oder nicht.
Was im Re-Test gleich bleiben muss
Ein Re-Test ist nur aussagekräftig, wenn ein stabiler Kern gleich bleibt. Halten Sie deshalb dieselben zentralen Prüffragen, dieselbe Auswertelogik und einen festen Vergleichssatz an Stichproben aufrecht. Ergänzen Sie dann gezielt die neuen Risikofälle. So erkennen Sie, ob eine Änderung tatsächlich verbessert, verschlechtert oder nur in andere Bereiche verlagert hat. Ohne diesen festen Kern entsteht bloß ein neues Einzelprojekt.
Die Novo-Lösungsseite zur Maschinendatenerfassung für Bestandsmaschinen formuliert passend, dass im Pilot Erkennung und Datenqualität geprüft werden sollten, bevor weitere Anlagen angebunden werden. Für Referenzdaten ist das die richtige Logik: erst lokal stabilisieren, dann skalieren. Ein Rollout darf nie der Moment sein, in dem Sie Grundfragen zu Zustandsdefinition, Zeitbezug oder Konfliktlösung noch offenlassen.
Teilweiser Re-Test mit festem Vergleichskern
Nicht jede Änderung erzwingt einen vollständigen Neustart des gesamten Referenzdatensatzes. Häufig ist ein teilweiser Re-Test sinnvoller: Sie behalten einen festen Vergleichskern aus bereits geprüften Situationen bei und ergänzen genau die Bereiche, die vom Änderungsrisiko betroffen sind. Dadurch bleibt die Vergleichbarkeit erhalten, ohne dass Sie jede ruhige Serienphase erneut komplett prüfen müssen.
Wichtig ist nur, dass der reduzierte Umfang begründet wird. Wenn etwa nur die Sensorposition an einer Maschine geändert wurde, ist ein Schwerpunkt auf Zustandsgrenzen, leisen Bearbeitungsphasen und Wiederanlauf plausibel. Wenn dagegen die Zustandsdefinition selbst geändert wurde, reicht ein enger Teiltest meist nicht aus. Dann betrifft das Risiko das Regelwerk und damit potenziell den gesamten Bewertungsraum.
Diese Unterscheidung sollte sichtbar im Re-Test-Protokoll stehen: Was bleibt aus dem Vergleichskern unverändert? Welche neuen Fenster kommen hinzu? Welche alten Ergebnisse dürfen weiterverwendet werden, welche nicht? Erst mit dieser Transparenz ist ein teilweiser Re-Test belastbar. Sonst entsteht nur der Eindruck, man habe „noch einmal draufgeschaut“, ohne die Geltung der alten und neuen Evidenz sauber zu trennen.
08 / PRAXISWISSEN
Beispielszenario: 180 Ein-Minuten-Fenster
Das folgende Szenario ist ausdrücklich ein Beispiel mit Annahmen, keine Messung und keine Freigabeschwelle. Es zeigt nur, wie Sie die wichtigsten Prüffragen transparent rechnen können. Beobachtet wird ein fest definierter Zeitraum von 180 Ein-Minuten-Fenstern. Jedes Fenster erhält nach dem Protokoll entweder ein eindeutiges Top-Level-Label oder den Status „Unbekannt“.
Beispielhafte Auswertung eines kleinen Referenzdatensatzes
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Fenster
92Bedeutung im Beispiel
Maschine verfolgt ihren Zweck aktivFenster
41Bedeutung im Beispiel
Maschine ist funktionsfähig, wartet aber externFenster
27Bedeutung im Beispiel
Technischer Grund innerhalb der MaschineFenster
12Bedeutung im Beispiel
Maschine ist als Objekt nicht verfügbarFenster
8Bedeutung im Beispiel
Evidenz reicht für keine belastbare ZuordnungFenster
180Bedeutung im Beispiel
Vollständiger BeobachtungsraumDie vier fachlichen Klassen ergeben zusammen 172 eindeutig gelabelte Fenster. Das entspricht einer Labelabdeckung von 95,56 %. Acht Fenster bleiben unbekannt, also 4,44 % des Beobachtungsraums. Schon diese beiden Werte sind nützlich, weil sie sichtbar machen, wie viel Ihrer späteren Modellbewertung auf abgesicherter Referenz basiert und wie viel bewusst außerhalb der Freigabe bleibt.
Angenommen, davon werden 60 konfliktanfällige Fenster doppelt gelabelt. In 9 Fällen weichen die Erstlabels voneinander ab. Dann beträgt die Erstkonfliktrate 15,00 %. Das ist noch keine Freigabeentscheidung, aber ein präziser Hinweis darauf, wie scharf oder unscharf Ihre Regeln an kritischen Stellen tatsächlich sind. Der wichtigste Nutzen liegt nicht in der Zahl selbst, sondern in der Liste der 9 Konflikte.
Für die Fehlalarmprüfung nehmen Sie zusätzlich bestätigte Nicht-Ereignis-Fenster auf. Angenommen, 70 solcher Fenster liegen vor und das zu prüfende System markiert in 6 davon trotzdem ein Ereignis. Dann liegt die Fehlalarmquote im Beispiel bei 8,57 %. Auch daraus folgt keine universelle Schwelle. Sie sehen damit nur transparent, wie groß das Alarmrauschen im definierten Bewertungsraum war.
So werden die Kennzahlen im Beispiel gerechnet
Der erste Rechenschritt ist rein additiv: 92 + 41 + 27 + 12 + 8 ergeben 180 Gesamtfenster. Danach trennen Sie die fachlich gelabelten Fenster von den unbekannten. Für die Abdeckung zählen deshalb nur die vier fachlichen Klassen. 92 + 41 + 27 + 12 ergeben 172 eindeutig gelabelte Fenster. Genau diese Trennung ist fachlich wichtig, weil unbekannte Fenster nicht stillschweigend in eine Fachklasse rutschen dürfen.
Die Labelabdeckung berechnen Sie dann als Anteil der eindeutig gelabelten Fenster am gesamten Beobachtungsraum: 172 geteilt durch 180 und anschließend mal 100. Daraus entstehen 95,56 %. Der Anteil unbekannter Fenster wird analog mit 8 geteilt durch 180 und mal 100 berechnet. Daraus ergeben sich 4,44 %. Beide Werte gehören zusammen, weil sie denselben Beobachtungsraum aus zwei Perspektiven beschreiben.
Für das Doppellabel-Beispiel bleibt die Bezugsmenge 60, nicht 180. Nur diese 60 konfliktanfälligen Fenster wurden von zwei Personen unabhängig geprüft. Wenn 9 davon abweichen, ergibt sich 9 geteilt durch 60 mal 100 und damit 15,00 %. Auch die Fehlalarmquote verwendet ihre eigene Bezugsmenge: 6 falsch markierte Nicht-Ereignis-Fenster geteilt durch 70 bestätigte Nicht-Ereignis-Fenster ergeben 8,57 %.
Wichtig ist, dass Sie diese Bezugsräume nicht vermischen. Labelabdeckung bezieht sich auf den gesamten Beobachtungsraum, Erstkonfliktrate auf den doppelt gelabelten Teil und Fehlalarmquote auf bestätigte Nicht-Ereignis-Fenster. Werden diese Nenner verwechselt, sehen Kennzahlen präzise aus, beantworten aber unterschiedliche Fragen. Genau deshalb gehört zu jeder Zahl in der Freigabeakte immer die dokumentierte Bezugsmenge.
Eine kleine Sensitivitätsbetrachtung zeigt, warum unbekannte Fenster betrieblich relevant sind. Wenn bei gleicher Gesamtmenge nicht 8, sondern 20 Fenster ungeklärt bleiben, sinkt die Labelabdeckung auf 88,89 %. An der Maschine selbst hat sich in diesem Gedankenexperiment nichts geändert. Verändert hat sich die Sicherheit Ihrer Freigabebasis. Genau deshalb lohnt es sich, unbekannte Fenster nicht zu kaschieren, sondern gezielt zu reduzieren.
Aus dem Beispiel folgt also keine Zahl, die Sie pauschal als Mindeststandard übernehmen sollten. Es zeigt nur die richtige Reihenfolge: erst den Beobachtungsraum sauber festlegen, dann Zustände summieren, dann Abdeckung und Konflikte offenlegen, dann bestätigte Nicht-Ereignis-Fenster für Fehlalarme ergänzen. Wer diese Reihenfolge einhält, kann seine Freigabe transparent begründen, statt nur ein Bauchgefühl zu protokollieren.
09 / PRAXISWISSEN
Wo dieser Leitfaden endet
Auch ein sauberes Referenzdaten-Protokoll hat Grenzen. Erstens liefert keine der gelesenen Quellen eine universelle, heute allgemein gültige Mindestschwelle für Labelabdeckung, Konfliktrate oder Fehlalarmquote. Solche Grenzwerte müssen Sie lokal und risikobezogen festlegen. Zweitens belegen Standardspezifikationen Begriffe und Modelllogik, aber nicht automatisch deren vollständige Implementierung in Ihrem Bestandspark.
Drittens ist Ground Truth nie frei von Aufwand. Der NIST-Rahmen macht gerade deutlich, dass es keine universelle Solid-Lösung für jede Anwendung gibt. Viertens erklärt eine Zustandsreferenz noch nicht automatisch betriebliche Ursachen, Maßnahmen oder OEE-Nenner. Wenn Sie tiefer in automatische Zustandserkennung einsteigen wollen, ist Maschinenzustände automatisch erkennen die passende Ergänzung. Wenn Sie die operative Alarmfreigabe vertiefen wollen, schließen Sie mit Fehlalarmen bei Maschinenüberwachung an.
Für den Einsatz externer Sensorik gilt eine nüchterne Entscheidungshilfe. Wenn Ihre Maschine bereits verlässliche native Zustände und verwertbare Monitoringinformationen liefert, sollten diese Quellen in der Referenzstrategie führend oder zumindest gleichrangig geprüft werden. Wenn genau das fehlt, kann eine Nachrüstung von außen sinnvoll sein, wie die Seite zur Maschinendatenerfassung für Bestandsmaschinen beschreibt. Entscheidend ist nicht der Kanal, sondern die dokumentierte Prüfbarkeit.
Zur Grenze des Leitfadens gehört auch: Er ersetzt keine lokale Freigabeentscheidung. Er strukturiert nur, welche Fragen vorliegen müssen, damit eine solche Entscheidung nachvollziehbar wird. Ob die vorliegende Referenz für einen reinen Pilot, für operative Alarme oder für weitergehende KPI-Nutzung reicht, bleibt eine Werkentscheidung auf Basis des dokumentierten Risikos und der konkret verfügbaren Evidenz.
Der praktische Endzustand dieses Leitfadens ist daher kein Diagramm, sondern eine belastbare Freigabeakte: Zustandsmodell, führende Referenzquelle, Stichprobenplan, Konfliktweg, Nachlabel-Historie und Re-Test-Regeln. Wenn diese Akte sauber geführt ist, können Sie KI-Auswertungen, Alarmregeln oder Zustandsmodelle deutlich nüchterner bewerten. Nicht weil dann alles sicher richtig ist, sondern weil Abweichungen endlich auf derselben Grundlage diskutiert werden.
In diese Freigabeakte gehören aus meiner Sicht mindestens sieben Dinge: Geltungsbereich, Version, Zustandsmodell, Quellenpriorität, Liste der Ausschlüsse, Review- und Konfliktlog sowie Re-Test-Trigger. Das ist keine zusätzliche Theorie, sondern der kleinste Satz, mit dem Sie in einigen Wochen noch erklären können, warum eine Referenz freigegeben wurde und unter welchen Bedingungen sie erneut geprüft werden muss.
10 / PRAXISWISSEN
Freigabe-Check für Referenzdaten zu Maschinenzuständen
Haken Sie ab, was Sie bereits geklärt haben. Die Auswahl bleibt nur während dieses Seitenbesuchs bestehen.
11 / PRAXISWISSEN
Weiterführende Fragen
Nicht pauschal. Sie können eine starke Referenzquelle sein, wenn Zustands- und Zeitlogik verlässlich dokumentiert sind. Für strittige Abschnitte oder Ursachenfragen kann eine Gegenquelle nötig sein, etwa Beobachtung, Protokoll oder ein separater Verlauf.
Die gelesenen Quellen nennen keine universelle Mindestgröße. Praktisch wichtig ist deshalb weniger eine starre Zahl als ein definierter Bewertungsraum mit normalen Phasen, Grenzfällen, bestätigten Nicht-Ereignissen und klaren Re-Test-Regeln nach Änderungen.
Nein, nicht stillschweigend. Unbekannte Fenster zeigen, wo die Evidenz für eine belastbare Klassifikation nicht ausreicht. Sie sollten als eigener Status dokumentiert und bei der Freigabe transparent berücksichtigt werden.
Nicht jede Änderung erzwingt ein komplettes Nachlabeln. Wenn sich jedoch Zustandsdefinition, Sensorposition, Modelllogik oder Prozesskontext so ändern, dass alte Regeln oder Zeitbezüge nicht mehr vergleichbar sind, braucht mindestens der betroffene Prüfumfang einen neuen Re-Test.