
NOVO AI · PRAXISLEITFADEN 20 MIN. LESEZEIT
Die Entscheidung auf einen Blick
Ein Maschinenüberwachung Pilotprojekt ist belastbar, wenn es nicht als Produktdemo, sondern als befristetes Prüfprotokoll mit klarer Freigabefrage aufgesetzt wird. Vor dem Start müssen Zweck, Datenquellen, Ground-Truth-Stichprobe, Bedienaufwand, IT/OT-Randbedingungen und die spätere Go/No-Go-Logik schriftlich feststehen. Sonst endet der Pilot mit hübschen Dashboards, aber ohne belastbare Rollout-Entscheidung.
Für Produktionsleiter ist die Kernfrage deshalb nicht, ob in vier Wochen „Daten sichtbar“ werden. Die bessere Frage lautet: Sind die erzeugten Zustände, Lückenhinweise und Alarme für unsere reale Linie ausreichend belastbar, wirtschaftlich vertretbar und in unserem Werk skalierbar? Genau darauf zielt das folgende 4‑Wochen-Protokoll. Es ist ausdrücklich ein Prüfprotokoll, keine Messergebnisse und kein eigener Praxistest.
Die Herleitung stützt sich auf gelesene Quellen zu technologie-neutralen Maschinenzuständen und Jobbezügen aus OPC UA for Machine Tools und umati, auf Sensor- und Kanalmodellierung aus NIST sowie auf OT-Randbedingungen des BSI. Novo AI veröffentlicht diesen Beitrag und ist selbst Anbieter; deshalb trennt der Text allgemeine Prüfschritte, Novo-spezifische Beispiele und hypothetische Rechenbeispiele bewusst voneinander.
01 / PRAXISWISSEN
Maschinenüberwachung Pilotprojekt: 4‑Wochen-Protokoll, Eingaben und Go/No-Go
Wenn Sie nur einen Abschnitt übernehmen, dann diesen. Das folgende Raster macht aus einem Testzugang oder einer Sensormontage ein vergleichbares Pilotprotokoll. Es zwingt alle Beteiligten dazu, dieselbe Freigabefrage, dieselbe Zeitbasis und dieselben Prüfkriterien zu verwenden. Das ist vor allem in Bestandsumgebungen wichtig, in denen Produktion, Instandhaltung und IT sonst unterschiedliche Erfolgsmaßstäbe anlegen.
Vergleichbares 4‑Wochen-Protokoll für ein Maschinenüberwachung-Pilotprojekt
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Eingabe
Pilotziel, Maschinenliste, Rollen, Wartungsfenster, ZeitmodellErwartete Ausgabe
Freigegebener Datenvertrag und OT/IT-FreigabePrüfung
Alle Beteiligten bestätigen Zweck, Begriffe, Zeitbezug und EskalationswegEingabe
Rohdaten, erste Zustände, BeobachterprotokollErwartete Ausgabe
Validierte Signal- und Zustandslogik je PilotmaschinePrüfung
Ground Truth deckt reale Starts, Stopps, Leerlauf und Randfälle abEingabe
Laufender Betrieb, Alarme, Nutzerfeedback, LückenfälleErwartete Ausgabe
Messung von Datenqualität, Fehlalarmen, Bedienaufwand und KalenderschnittPrüfung
Wöchentliche Review mit Fehlerlog und KorrekturentscheidungenEingabe
Verdichtete Pilotdaten, Review-Protokolle, GegenprobenErwartete Ausgabe
Go-, Nacharbeits- oder No-Go-EntscheidungPrüfung
Entscheidungsmatrix mit dokumentierten Freigabegrenzen und Grenzen des PilotenDie wichtigste Regel lautet: Ein Pilot darf nur eine konkrete Freigabefrage beantworten. Beispiele sind: „Reicht die Zustandsqualität für Schichttransparenz an vier Engpassmaschinen?“, „Ist die Alarmierung für längere Stillstände im Werk belastbar?“ oder „Lässt sich ein Brownfield-Ansatz ohne Eingriff in die SPS organisatorisch skalieren?“ Wer zusätzlich vollständige OEE, automatische Ursachenklassifikation, ERP-Kopplung und Energieoptimierung in denselben vier Wochen erzwingen will, verwischt die Aussagekraft.
Für die spätere Rollout-Entscheidung genügt es nicht, dass eine Plattform irgendetwas erkennt. Sie müssen wissen, welche Datenquelle wofür als führend gilt, welche Ereignisse manuell gegengeprüft wurden, wie viel Nacharbeit im Alltag anfiel und ob der Aufbau unter Werkbedingungen stabil blieb. Genau deshalb trennt dieses Protokoll Datenquelle, Prüfmethode, Bedienaufwand und OT-Risiko voneinander.
02 / PRAXISWISSEN
Pilotziel vor Produktdemo: Was der Pilot beweisen muss
Der Pilot sollte mit einer operativen Entscheidung beginnen, nicht mit einer Funktionsliste. In den gelesenen Standards ist dokumentiert, dass Maschinenzustände und Jobbezüge technologie-neutral beschrieben werden können, damit Maschinen unterschiedlicher Hersteller an übergeordnete Systeme angebunden werden können OPC UA for Machine Tools. Daraus folgt aber nicht, dass Ihr Werk schon dieselbe Begriffslogik für Produktion, Leerlauf, Rüsten, Pause und Störung verwendet.
Genau an dieser Stelle entstehen in Pilotprojekten leicht unterschiedliche Erwartungen. Das technische Team freut sich über ankommende Signale, die Produktion über eine neue Zeitleiste und das Management über einen schnellen Start. Nach vier Wochen kann sonst offenbleiben, ob die Zeitachse wirklich schichtfähig ist, ob Datenlücken sichtbar werden, wie viel der Bediener eingreifen muss und ob dieselbe Logik an der nächsten Maschine noch funktioniert. Der Pilot braucht deshalb von Beginn an eine eingefrorene Freigabefrage.
Nur einen ersten Nutzungszweck freigeben
Ich empfehle, für den Pilot genau einen primären Nutzen festzulegen: etwa Stillstandstransparenz, Schichtvergleich, Eskalation längerer Unterbrechungen oder belastbare Zustandszeiten für Engpassmaschinen. Das ist bewusst enger als eine umfassende Digitalisierungsstory. Schon die interne Seite Maschinenüberwachung ohne IT-Kenntnisse ordnet einen schrittweisen Brownfield-Einstieg ein. Ein Pilot ist deshalb eher ein Freigabetor als ein endgültiges Zielbild.
Wichtig ist auch die Grenze zu OEE-nahen Auswertungen. Die Standards zu Maschinenzuständen und Job Management helfen beim Strukturieren von Daten, ersetzen aber nicht Ihre lokale Definition des KPI-Nenners. Aus einem dokumentierten Jobbezug folgt nicht automatisch, dass dieselbe Zeitbasis für Ihre OEE-Regel gilt. Diese Abgrenzung sollte im Pilot ausdrücklich benannt werden, statt später implizit in Dashboards zu verschwinden.
Maschinen bewusst auswählen, nicht einfach die bequemsten
Eine belastbare Pilotgruppe sollte nicht nur aus der am leichtesten zugänglichen Maschine bestehen. Sinnvoller ist eine kleine Mischung aus mindestens drei Rollen: erstens eine stabile Referenzmaschine mit gut beobachtbarem Ablauf, zweitens eine kritische Maschine mit häufigen Unterbrechungen oder unsicheren Übergängen, drittens eine ältere oder organisatorisch wichtige Bestandsmaschine. So prüfen Sie nicht nur Funktion, sondern auch Übertragbarkeit.
Als Novo-Beispiel lässt sich die interne Fallstudie zu 118 Maschinen unterschiedlicher Baujahre heranziehen. Belegt ist dort, dass in einem Projekt 118 Maschinen der Baujahre 1998 bis 2014 überwacht wurden und akustische Signale sowie Vibrationen mit dem tatsächlichen Maschinenbetrieb validiert wurden. Daraus folgt aber gerade nicht, dass jeder Maschinentyp, jeder Hersteller oder jede Ursachelogik automatisch gleich gut im ersten Pilot abbildbar ist.
Datenvertrag und Rollen vor der ersten Messung festziehen
Vor der Woche 1 brauchen Sie einen kleinen Datenvertrag. Darin stehen pro Pilotmaschine mindestens: führende Maschinenkennung, Zeitquelle, Schichtkalender, geplante Ausschlusszeiten, Zustandsdefinitionen, Ground-Truth-Verfahren, Review-Takt, Eskalationsweg und Freigabeinstanz. Dieser Vertrag ist keine Formalität. Er verhindert, dass später dieselben Rohdaten von Produktion, IT und Instandhaltung unterschiedlich interpretiert werden.
Ebenso wichtig ist die Rollenklärung. Produktion bewertet die betriebliche Plausibilität, Instandhaltung prüft Montage- und Signalfragen, IT oder OT-Verantwortliche beurteilen Netz, Rechte und Datenfluss. Ohne diese Dreiteilung kippt der Pilot leicht in eine einseitige Wahrnehmung: Entweder „technisch funktioniert es doch“ oder „der Schichtführer mag es nicht“. Beides allein reicht für Go oder No-Go nicht aus.
03 / PRAXISWISSEN
Drei Datenquellen im Pilot: Standardschnittstelle, Retrofit-Sensorik, Ground Truth
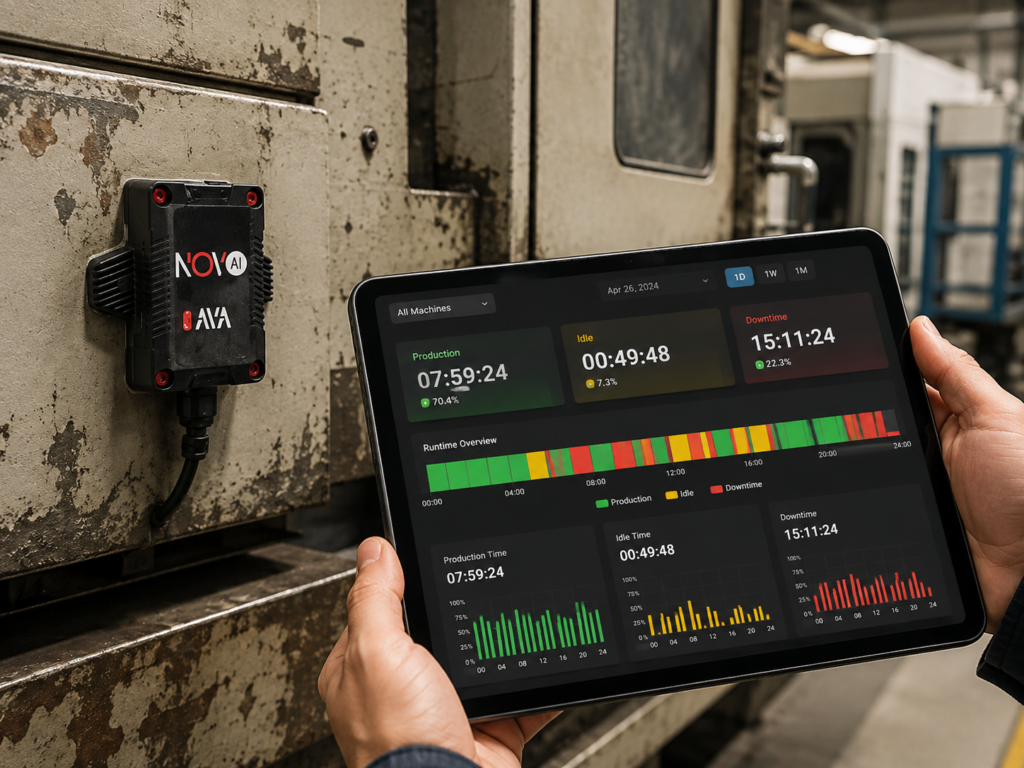
Ein guter Pilot nutzt nicht nur eine Datenquelle. Er kombiniert mindestens eine automatische Quelle für den laufenden Betrieb mit einer unabhängigen Prüfmethode. Die gelesenen Quellen helfen dabei, die Rollen der Datenquellen sauber zu trennen: OPC UA for Machine Tools und umati beschreiben herstellerübergreifende Maschinenzustände und Jobbezüge; NIST betont Sensor- und Kanalmodell, Kalibrierung und Signalaufbereitung; ein Beobachterlog liefert die lokale Ground Truth.
Welche Datenquelle im Pilot wofür taugt
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Standardschnittstelle OPC UA/umati
Technologie-neutrale Zustände, Maschinenidentität und Jobbezug dokumentierenExterne Retrofit-Sensorik
Brownfield-Zustände ohne tiefen Steuerungseingriff sichtbar machen und lokal validierenManuelle Ground Truth
Reale Ereignisse als unabhängige Referenz für Stichproben und Streitfälle festhaltenStandardschnittstelle OPC UA/umati
Skalierbare Begriffs- und Schnittstellenbasis über Hersteller hinwegExterne Retrofit-Sensorik
Schneller Realitätsbezug an Bestandsmaschinen, wenn direkter Datenzugang begrenzt istManuelle Ground Truth
Trennt sichtbare Zeitleiste von tatsächlichem Shopfloor-AblaufStandardschnittstelle OPC UA/umati
Dokumentierter Standardumfang sagt noch nichts über lokale Implementierung ausExterne Retrofit-Sensorik
Zustandslogik muss an realem Prozess validiert werden; Ursachelogik kann Zusatzkontext erfordernManuelle Ground Truth
Nicht dauerhaft skalierbar als Primärquelle, deshalb nur stichprobenartig einsetzenStandardschnittstelle OPC UA/umati
Zeitmodell, Zustandssemantik, Job- und KalenderschnittExterne Retrofit-Sensorik
Signalvalidierung, Fehlalarme, Bedienaufwand und Übertragbarkeit auf weitere MaschinenManuelle Ground Truth
Beobachterkonsistenz, Zeitabgleich, Auswahl kritischer RandfälleFür Produktionsleiter ist dabei ein Punkt besonders wichtig: Keine dieser Quellen ersetzt die anderen vollständig. Eine saubere Standardschnittstelle kann fachlich stark sein, deckt aber die lokale Implementierung nicht automatisch ab. Eine Retrofit-Lösung kann an Bestandsmaschinen schnell Transparenz erzeugen, beweist aber ohne Gegenprobe noch nicht die Richtigkeit jeder Zustandsgrenze. Ein Beobachterlog ist glaubwürdig, aber allein nicht skalierbar.
Die NIST-Veröffentlichung ist hier nützlich, weil sie Sensoren nicht nur als Messwertlieferanten, sondern als modellierte Einheiten mit Kanälen, Kalibrierung und Signalaufbereitung beschreibt NIST. Für den Pilot heißt das praktisch: Dokumentieren Sie je Datenquelle, welcher Kanal welchen physikalischen Zusammenhang abbildet, welche Vorverarbeitung stattfindet und wann eine Neuvalidierung nötig wird. Sonst bleibt unklar, ob ein Grenzfall wirklich ein Prozessereignis oder nur ein Auswerteartefakt war.
Wenn Sie einen Brownfield-Einstieg planen, kann zusätzlich ein Blick in den internen Produktionsmonitoring-Systemvergleich helfen, um die Pilotfrage von einer späteren Systementscheidung zu trennen. Für dieses Protokoll reicht aber eine einfachere Logik: Im Pilot zählt nicht die breiteste Feature-Liste, sondern die belastbarste Beweiskette für Ihre konkrete Freigabefrage.
04 / PRAXISWISSEN
Vier Wochen im Takt: Der eigentliche Prüfplan
Der Pilot braucht einen festen Rhythmus. Zwei bis sechs Wochen sind nur dann aussagekräftig, wenn jede Woche einen klaren Prüfzweck hat. Ich empfehle für einen Standardfall vier Phasen: Woche 0 für Freigaben und Begriffe, Woche 1 für Signalvalidierung, Woche 2 und 3 für Betrieb unter Alltagseinfluss, Woche 4 für Verdichtung und Entscheidung. Dieser Aufbau ist eine Empfehlung, keine Norm.
Woche 0: Freigabefrage, Kalender und Eskalation festziehen
Vor dem technischen Start sollte jede Pilotmaschine eine Freigabekarte erhalten. Darauf stehen Pilotziel, gewünschte Zustände, Verantwortliche, geplante Produktionszeiten, Ausschlusszeiten, erwartete Randfälle und die Frage, welche Ereignisse manuell gegengeprüft werden. Zusätzlich legen Sie fest, wer bei Datenlücken, Falschmeldungen oder OT-Problemen sofort entscheiden darf und welche Eingriffe bis zum nächsten Wartungsfenster warten müssen.
In dieser Phase werden auch die Review-Termine fixiert. Ein 15‑ bis 30‑minütiges Wochenreview kann ausreichen, wenn das Fehlerlog diszipliniert geführt wird: Was ist passiert, welche Daten liegen vor, war es ein Prozessereignis, ein Bedienfall oder ein technischer Fehler, welche Wirkung hat die Korrektur? Ohne diesen Takt wird aus vier Wochen Pilot schnell nur eine lose Sammlung von Einzelfällen.
Woche 1: Zustände gegen reale Abläufe validieren
In Woche 1 geht es nicht um Vollständigkeit, sondern um Trennschärfe. Beobachten Sie gezielt echte Starts, Stopps, Leerlaufphasen, geplante Pausen, Materialwarten, Rüstvorgänge und kurze Unterbrechungen. Dokumentiert wird jeweils nicht nur, dass ein Ereignis stattfindet, sondern auch, ob die automatische Erkennung Anfang, Dauer und Ende plausibel abbildet. Erst dann taugt die Zustandslogik für längere Pilotstrecken.
Hilfreich ist ein Beobachterprotokoll mit festen Spalten: Maschinenkennung, Uhrzeit Start, Uhrzeit Ende, beobachteter Zustand, Besonderheit, vermutete Ursache, Parallelereignis und Freitext. Die Einträge sollten mit einer eindeutig dokumentierten Uhr geführt werden. Schon kleine Zeitverschiebungen machen spätere Diskussionen unnötig schwer, weil dann nicht mehr klar ist, ob ein Unterschied technisch oder nur zeitlich bedingt war.
Woche 2 und 3: Alltagseinfluss, Fehlalarme und Bedienaufwand messen
Jetzt zählt nicht mehr nur die Einzelszene, sondern das Verhalten über Schichten, Auftragswechsel und normale Störungen hinweg. Halten Sie deshalb nicht nur Falschmeldungen fest, sondern auch Bedienaufwand: Wer musste etwas bestätigen, korrigieren oder nachtragen? Wie lange dauerte das? War der Eingriff einmalig zur Kalibrierung oder wiederkehrend im Alltag? Diese Frage ist für die spätere Skalierung sehr relevant.
Ebenso wichtig sind Datenlücken- und Zeitmodelleffekte. Prüfen Sie, ob alle Beteiligten denselben Schichtschnitt sehen, ob Start und Ende von Pausen konsistent behandelt werden und ob unklare Abschnitte explizit markiert sind. Wo Zustände, Zeitbezug und Ursachebuchung durcheinanderlaufen, entstehen sonst Scheingenauigkeiten. Für die spätere Freigabe sollten technische Unsicherheiten daher als eigene Klasse sichtbar bleiben.
Woche 4: Verdichten, Grenzen benennen, Entscheidung treffen
Die Schlusswoche dient nicht dem Nachpolieren, sondern der ehrlichen Verdichtung. Fassen Sie pro Maschine zusammen: beobachteter Zeitraum, manuell geprüfte Stichprobe, bekannte Randfälle, unklare Zeit, relevante Falschmeldungen, tatsächlicher Bedienaufwand, offene OT-Themen und Eignung für den ursprünglich definierten Nutzungszweck. Genau hier entscheidet sich, ob ein Pilot wirklich rolloutfähig ist oder nur im Testfenster gut aussah.
Für die Review-Diskussion ist eine Verlaufsansicht mit Zustandsband und Zyklusmarkierungen oft hilfreich, weil sie Chronologie, Randfälle und längere Phasen schneller sichtbar macht. Ein passender Novo-Clip ist die WatchMen-Maschinenhistorie mit Zustandsband und Zyklusmarkierungen; ich nutze ihn hier nur als thematisch passende Ansichtsergänzung, nicht als Beleg für Toninhalte oder als eigener Testnachweis.
- Pilotfrage fixieren: Formulieren Sie schriftlich, welche eine betriebliche Entscheidung der Pilot freigeben soll.
Ergebnis: eindeutiger Nutzungszweck.
Prüfung: Jede spätere Kennzahl muss direkt auf diese Frage einzahlen. - Maschinen und Randfälle auswählen: Nehmen Sie mindestens eine stabile, eine problematische und eine ältere oder organisatorisch kritische Maschine auf.
Ergebnis: aussagekräftige Pilotgruppe.
Prüfung: Die Gruppe deckt reale Varianz ab, nicht nur die bequemste Maschine. - Datenvertrag einfrieren: Legen Sie Zeitmodell, Zustandsbegriffe, Ausschlusszeiten, Review-Takt und Eskalationsweg fest.
Ergebnis: gemeinsame Semantik.
Prüfung: Produktion, Instandhaltung und IT bestätigen dieselben Begriffe. - Ground Truth planen: Reservieren Sie Beobachtungsfenster für Starts, Stopps, Pausen, Auftragswechsel und Grenzfälle.
Ergebnis: unabhängige Gegenprobe.
Prüfung: Die Stichprobe enthält bewusst auch schwierige Situationen. - Alltagsbetrieb loggen: Führen Sie Fehlerlog, Bedienaufwand-Log und wöchentliche Reviews.
Ergebnis: belastbare Aussage zu Pflegeaufwand und Stabilität.
Prüfung: Wiederkehrende Eingriffe sind von Einmaleffekten getrennt. - Go/No-Go entscheiden: Bewerten Sie Nutzungszweck, Datenqualität, Aufwand und OT-Tauglichkeit gemeinsam.
Ergebnis: dokumentierte Freigabe, Nacharbeit oder Stopp.
Prüfung: Jede Entscheidung verweist auf konkrete Beobachtungen und Grenzen.
05 / PRAXISWISSEN
IT/OT-Check vor dem Start: Verfügbarkeit zuerst
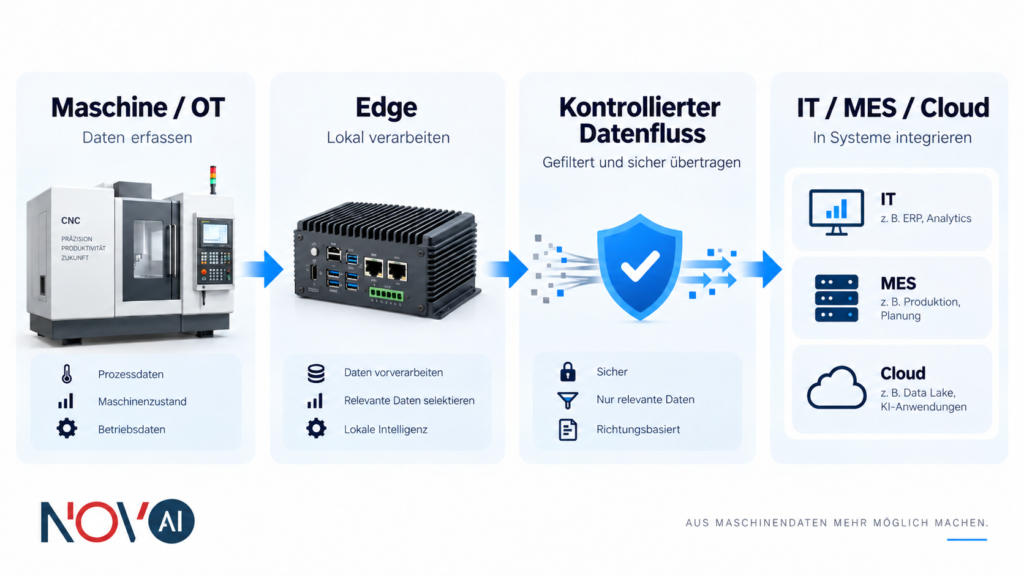
Ein Maschinenüberwachungs-Pilot kann an der Sensorik scheitern; ebenso kann er mit OT-Realitäten kollidieren, die in klassischen IT-Projekten anders gewichtet werden. Das BSI beschreibt ausdrücklich, dass industrielle Steuerungs- und Automatisierungssysteme andere Prioritäten bei den Schutzzielen haben und sich dies unter anderem in längeren Betriebszeiten, seltenen Wartungsfenstern und Echtzeitanforderungen zeigt BSI.
Für den Pilot heißt das: Verfügbarkeit ist kein Randthema, sondern Zulassungsvoraussetzung. Bevor irgendetwas montiert, verbunden oder ausgerollt wird, sollte schriftlich feststehen, welche Änderungen erlaubt sind, wann sie durchgeführt werden dürfen und welche Rückfalloption es bei Störungen gibt. Ein technisch reizvoller Pilot, der ungeplante Produktionsunterbrechungen provoziert oder unklare Verantwortlichkeiten in der Schicht erzeugt, ist operativ nicht belastbar.
Fünf OT-Fragen, die vor dem Start beantwortet sein müssen
Erstens: Welche Komponente darf im Pilot ausfallen, ohne den Produktionsprozess zu beeinflussen? Zweitens: Welches Wartungsfenster ist für Montage, Netzwerkfreigabe oder Korrektur tatsächlich nutzbar? Drittens: Wer entscheidet bei einem Störungsverdacht sofort über Abschalten, Trennen oder Weiterlaufen? Viertens: Wie werden Logs und Rohdaten gesichert, wenn ein Incident untersucht werden muss? Fünftens: Welche Rechte haben externe Beteiligte oder Dienstleister im Werknetz wirklich?
Diese Fragen sind bewusst schlicht formuliert, weil sie im Alltag mehr Wirkung haben als ein abstraktes Security-Kapitel. Gerade im Pilot werden Eingriffe gern als temporär behandelt. In OT-Umgebungen ist temporär aber nicht harmlos. Ein nur für vier Wochen aufgesetzter Test kann dieselben Verantwortungs- und Verfügbarkeitskonflikte auslösen wie eine dauerhafte Lösung. Deshalb gehört der OT-Check vor den ersten Messwert, nicht erst vor den Rollout.
Lokale Datenverarbeitung ist eine Architekturfrage, kein Glaubenssatz
Aus den gelesenen Quellen folgt nicht, dass jede Pilotarchitektur zwingend lokal rechnen muss. Sie belegen aber, dass OT-Bedingungen wie Verfügbarkeit, Wartungsfenster und begrenzte Übertragbarkeit klassischer Office-IT-Maßnahmen ernst genommen werden müssen BSI. Für Ihren Pilot sollte daher dokumentiert werden, welche Daten wo entstehen, wo sie verarbeitet werden, wann sie das Werk verlassen und welche Funktion bei Verbindungsproblemen lokal erhalten bleiben muss.
Wenn Sie eine Brownfield-Einführung ohne tiefen SPS-Eingriff prüfen, kann die interne Seite Maschinenüberwachung ohne IT-Kenntnisse als organisatorische Einordnung nützlich sein. Für die Pilotfreigabe zählt aber nicht das Versprechen einfacher Einführung, sondern der belegte Umgang mit Verfügbarkeit, Rollen und Störfällen an Ihrer konkreten Linie.
06 / PRAXISWISSEN
Ground Truth ohne Theater: Stichprobe, Randfälle, Beobachterlog
Ground Truth bedeutet im Pilot nicht, dass Sie vier Wochen lang neben der Maschine stehen. Es bedeutet, dass Sie eine gezielte, dokumentierte Referenzstichprobe planen, die schwierige und entscheidungsrelevante Situationen abdeckt. Ziel ist nicht die perfekte Vollerhebung, sondern eine aussagekräftige Gegenprobe für Start-, Stopp- und Übergangsszenen, Schichtgrenzen, Leerlaufphasen und Unsicherheiten in der Zustandsklassifikation.
Der NIST-Beitrag zur Sensorinteroperabilität ist dafür hilfreich, weil er Sensor und SensorChannel mitsamt Kalibrierung und Signalaufbereitung als eigenständige Beschreibungsobjekte fasst NIST. Übertragen auf den Pilot heißt das: Notieren Sie nicht nur das Ergebnis „lief“ oder „stand“, sondern auch, welcher Kanal, welches Muster oder welcher Kontext gerade relevant war. Das macht spätere Korrekturen nachvollziehbar.
Welche Stichprobenfenster in vier Wochen sinnvoll sind
Ich empfehle, die Stichprobe nicht gleichmäßig, sondern ereignisorientiert zu verteilen. Sinnvoll sind Beobachtungsfenster an Schichtstart, kurz vor Pausen, direkt nach Pausen, bei Materialwechseln, beim Auftragswechsel, in bekannten Störphasen und in mindestens einem ruhigen Referenzabschnitt. So erfassen Sie sowohl den Normalzustand als auch jene Randlagen, in denen Signale und betriebliche Realität besonders leicht auseinanderlaufen.
Wie lang diese Fenster sein müssen, hängt vom Prozess ab. Bei häufigen Zyklen können 20 bis 30 Minuten schon viel aussagen. Bei langen Durchlaufzeiten oder seltenen Umrüstungen sind längere Fenster nötig. Wichtig ist weniger die starre Dauer als die dokumentierte Abdeckung kritischer Situationen. Ein Pilot, der nur glatte Produktionsphasen beobachtet, prüft die leichteste Aufgabe und verfehlt die eigentliche Freigabefrage.
Beobachterlog knapp, aber prüfbar halten
Das Beobachterlog muss alltagstauglich bleiben. Ich empfehle pro Eintrag nur Felder, die später wirklich verglichen werden: Zeitbeginn, Zeitende, beobachteter Zustand, Kontext, Unsicherheitsvermerk und Initialen des Beobachters. Ergänzen Sie nur dann weitere Felder, wenn sie für die Freigabefrage notwendig sind. Zu komplexe Formulare werden im Schichtalltag unzuverlässig gepflegt und schwächen gerade dadurch die Gegenprobe.
Ebenso wichtig ist die Verifikation des Logs selbst. Nutzen Sie nach Möglichkeit zwei kurze Doppelbeobachtungen durch unterschiedliche Personen. Wenn dieselbe Szene von zwei Beobachtern deutlich unterschiedlich protokolliert wird, ist nicht die Plattform das erste Problem, sondern die lokale Begriffslogik. Diese Form der Selbstprüfung kostet wenig Zeit und vermeidet spätere Scheinsicherheit in der Referenz.
Ground Truth ist keine Dauerlösung für den Rollout
Ein zentraler Fehler besteht darin, einen guten Beobachterprozess mit einer skalierbaren Betriebslogik zu verwechseln. Ground Truth ist im Pilot eine Prüfquelle, nicht das spätere Zielsystem. Sobald Sie mit manuellen Referenzschichten dauerhaft nachsteuern müssen, ist der Nutzwert der Automatisierung zu hinterfragen. Ein guter Pilot misst deshalb nicht nur die Abweichung zur Ground Truth, sondern auch, wie viel Ground Truth künftig noch nötig wäre.
Genau daraus leitet sich der Bedienaufwand-Log ab: Jede manuelle Nachjustierung, Korrektur oder Zusatzbuchung gehört mit Zeitbedarf in das Protokoll. Ohne diese zweite Ebene können Sie zwar die inhaltliche Qualität eines Piloten bewerten, nicht aber seine wirtschaftliche und organisatorische Tragfähigkeit im späteren Alltag.
07 / PRAXISWISSEN
Messgrößen, Abbruchkriterien und Bedienaufwand
Ohne vorab definierte Messgrößen wird die Auswertung leicht uneinheitlich. Deshalb sollten Sie vor Woche 1 festlegen, welche vier bis sechs Kriterien über Freigabe, Nacharbeit oder Abbruch entscheiden. Diese Kriterien sind lokale Werkregeln, keine universellen Grenzwerte aus einer Norm. Die Quellen belegen Struktur und Randbedingungen, nicht Ihre betriebliche Toleranz für Aufwand oder Unsicherheit.
Empfohlene Messgrößen für ein neutrales Pilotprotokoll
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Wie messen?
Anteil aller Pilotstunden, die technisch oder fachlich nicht belastbar klassifiziert sindWarum wichtig?
Ohne sichtbare Unsicherheit entstehen ScheingenauigkeitenWas als Warnsignal dokumentieren?
Wachsende Quote, gehäufte Lücken nach Restart oder SchichtgrenzeWie messen?
Gezählte und beschriebene Fälle mit Ground-Truth-VerweisWarum wichtig?
Einige wenige, aber systematische Fehler kippen die AkzeptanzWas als Warnsignal dokumentieren?
Gleicher Grenzfall tritt wiederholt auf mehreren Maschinen aufWie messen?
Minuten pro Maschine und Woche für Nacharbeit, Bestätigung oder UrsachenpflegeWarum wichtig?
Dauerhafter Zusatzaufwand begrenzt die SkalierbarkeitWas als Warnsignal dokumentieren?
Wiederkehrender Schichtaufwand statt einmaliger KalibrierungWie messen?
Vergleich geplanter Pausen, Schichtwechsel und AuftragsgrenzenWarum wichtig?
Falscher Schnitt verfälscht Berichte, obwohl Signale formal korrekt wirkenWas als Warnsignal dokumentieren?
Identische Situationen landen mal in alter, mal in neuer SchichtWie messen?
Incident-Log, Wartungsfenster, ungeplante EingriffeWarum wichtig?
Auch gute Daten sind wertlos, wenn der Betrieb dadurch belastet wirdWas als Warnsignal dokumentieren?
Ungeplante Neustarts, Rechtekonflikte, ungeklärte VerantwortungenWie messen?
Prüfen, ob Roh- oder Verlaufsdaten nachvollziehbar exportiert und geprüft werden könnenWarum wichtig?
Ohne Prüfbarkeit bleibt der Pilot eine BlackboxWas als Warnsignal dokumentieren?
Review stützt sich nur auf Screenshots statt auf prüfbare DatensichtenFür die Diskussion im Projektteam ist entscheidend, dass Fehlalarm, Datenlücke und Bedienaufwand getrennte Messgrößen bleiben. Eine geringe Fehlalarmzahl kann teuer sein, wenn jede Korrektur viele Minuten dauert. Umgekehrt kann eine kleine Quote unklarer Zeit vertretbar sein, wenn sie sichtbar markiert und für kritische Auswertungen ausgeschlossen bleibt. Erst die getrennte Betrachtung macht die spätere Rollout-Entscheidung belastbar.
Ich empfehle außerdem zwei Arten von Abbruchkriterien: harte und weiche. Harte Kriterien betreffen Sicherheit, Verfügbarkeit oder unklare Verantwortlichkeit im OT-Betrieb. Weiche Kriterien betreffen Nutzen, Komfort und Nacharbeitsbedarf. Ein Pilot kann also inhaltlich vielversprechend sein und dennoch gestoppt werden, wenn der Eingriff organisatorisch oder betrieblich nicht sauber beherrscht wird. Diese Trennung spart im Review viel Streit.
Wenn Sie später in die formale Freigabe nach dem Pilot gehen, ist das interne MDE-Abnahmeprotokoll für Bestandsmaschinen die passendere Vertiefung. Dieser Beitrag hier endet bewusst früher: bei der Frage, ob ein zwei- bis sechswöchiger Pilot überhaupt freigabefähige Belege für den Rollout erzeugt hat.
08 / PRAXISWISSEN
Beispielrechnung: Ein 4‑Wochen-Pilot ohne Schönrechnen
Das folgende Beispiel ist ausdrücklich hypothetisch. Es zeigt, wie Sie einen Pilot sauber lesen können, ohne aus einzelnen positiven Screenshots vorschnell einen Rollout abzuleiten. Die Zahlen sind Annahmen, keine Novo-Kundenwerte und keine allgemeingültigen Grenzwerte. Entscheidend ist die Rechenlogik: gleiche Zeitbasis, klare Zeitklassen und ein sichtbarer Zusammenhang zwischen Datenqualität, Ground Truth und Bedienaufwand.
Angenommen, der Pilot umfasst vier Wochen mit 20 Betriebstagen und zwei produktionsrelevanten Schichten pro Tag. Die geplante Beobachtungszeit beträgt damit 20 Tage × 16 Stunden = 320 Stunden. Für diese 320 Stunden dokumentieren Sie vier Zeitklassen: 212 Stunden Produktion, 46 Stunden Leerlauf, 38 Stunden Stillstand und 24 Stunden unklare oder technisch nicht belastbare Zeit. Die Summe ergibt wieder exakt 320 Stunden.
Der Anteil unklarer Zeit beträgt in diesem Beispiel 24 / 320 × 100 = 7,5 %. Zusätzlich wurden 24 Stunden Ground Truth über gezielte Beobachtungsfenster protokolliert. Das entspricht ebenfalls 24 / 320 × 100 = 7,5 % der gesamten Beobachtungszeit. Für das Projektteam könnte diese Abdeckung ausreichend sein, wenn die 24 Stunden die wirklich kritischen Randfälle enthalten und nicht nur einfache Produktionsphasen.
Nehmen wir weiter an, dass über vier Pilotmaschinen insgesamt 16 Stunden Bedienaufwand für Korrekturen, Bestätigungen und Review-Nacharbeit anfielen. Dann ergeben sich 16 / 4 = 4,0 Stunden Bedienaufwand je Maschine über den gesamten Pilot. Auf vier Wochen verteilt sind das 4,0 / 4 = 1,0 Stunde je Maschine und Woche. Genau dieser Wert ist für einen Rollout oft aussagekräftiger als eine einzelne gute Alarmdemo.
Jetzt kommt die Sensitivität. Wenn nicht 24, sondern 32 Stunden unklar geblieben wären, läge der Anteil unklarer Zeit bei 32 / 320 × 100 = 10,0 %. Wenn Ihr Werk vorab als eigene Regel festgelegt hätte, dass oberhalb von 8,0 % unklarer Zeit keine Rollout-Freigabe erfolgt, würde derselbe Pilot von „nacharbeitbar“ auf „No-Go oder begrenzte Nacharbeit“ kippen. Darum müssen Grenzwerte vor dem Start definiert werden, nicht erst nach einem guten oder schlechten Bauchgefühl.
Wichtig ist auch, was diese Rechnung nicht beweist. Sie sagt nichts über Outputsteigerung, ROI oder OEE-Verbesserung aus. Sie beantwortet nur, ob die beobachtete Zeitbasis, die Gegenprobe und der organisatorische Aufwand für den geplanten Nutzungszweck plausibel genug sind. Genau diese Bescheidenheit macht eine Pilotrechnung nützlich. Sie ersetzt Vermutung durch prüfbare Zwischenschritte, ohne mehr zu behaupten als belegt ist.
09 / PRAXISWISSEN
Go, Nacharbeit oder No-Go: Die Entscheidungslogik
Am Ende des Piloten sollten Sie keine freie Diskussion führen, sondern eine dokumentierte Matrix anwenden. Dadurch wird die Entscheidung wiederholbar und weniger vendor-gesteuert. Vor allem verhindert die Matrix, dass ein Pilot wegen einer beeindruckenden Einzelansicht freigegeben wird, obwohl Datenlücken, Schichtprobleme oder hoher Bedienaufwand noch ungelöst sind. Die Entscheidung muss auf derselben Freigabefrage beruhen, die in Woche 0 festgelegt wurde.
Empfohlene Go/No-Go-Matrix nach vier Wochen
Wählen Sie ein Kriterium. Die Optionen stehen direkt nebeneinander.
Wann passend?
Datenqualität, Ground Truth und Aufwand sind für den definierten Nutzen plausibel; OT-Betrieb bleibt stabilWas muss dokumentiert sein?
Freigegebener Nutzungszweck, bekannte Grenzen, offene Restpunkte mit TerminNächster Schritt
Rollout auf ähnliche Maschinen oder Schichten mit gleicher PrüflogikWann passend?
Nutzen erkennbar, aber einzelne Grenzfälle, Kalenderprobleme oder Aufwand noch zu hochWas muss dokumentiert sein?
Konkrete Fehlerliste, priorisierte Korrekturen, begrenzter Re-Test-UmfangNächster Schritt
Kurzer Re-Test an denselben kritischen Fällen statt kompletter NeustartWann passend?
Freigabefrage bleibt unbeantwortet oder OT-/Datenrisiken sind für den Zweck zu hochWas muss dokumentiert sein?
Klare Begründung je Kriterium, keine pauschale Ablehnung ohne NachweisNächster Schritt
Alternative Datenquelle, engerer Nutzungszweck oder anderer PilotzuschnittEin ehrliches Go kann enger ausfallen, als Vertriebsfolien vermuten lassen. Es kann völlig legitim sein, nur die Zustandszeiten für Engpasstransparenz freizugeben, aber OEE, automatische Ursachenklassifikation oder Linienvergleich noch nicht. Genauso legitim ist ein No-Go, wenn der Bedienaufwand im Alltag zu hoch bleibt oder OT-Verantwortliche den Betrieb nur unter zu vielen Ausnahmen akzeptieren. Ein gescheiterter Pilot spart oft mehr Geld als ein voreiliger Rollout.
Wenn Sie verschiedene Lösungsansätze gegeneinander prüfen wollen, sollten Sie dafür einen getrennten Dokumentations- oder Systemvergleich aufsetzen. Der passende interne Einstieg dafür ist der Produktionsmonitoring-Systemvergleich. Dieses Pilotprotokoll beantwortet eine andere Frage: Ist unser Pilot mit dieser Datenbasis und unter diesen Werkbedingungen belastbar genug für den nächsten Schritt?
Wann eine andere Lösung geeigneter sein kann
Eine steuerungsnahe Lösung kann geeigneter sein, wenn Ihr primäres Ziel ein standardisierter, direkt dokumentierter Maschinen- und Jobbezug über kompatible Schnittstellen ist. Darauf weisen OPC UA for Machine Tools und umati hin. Ein Brownfield-Retrofit-Ansatz kann geeigneter sein, wenn Bestandsmaschinen organisatorisch oder technisch schwer direkt angebunden werden können. Welche Variante besser passt, muss der Pilot gerade erst belastbar zeigen.
Für Novo AI gilt in diesem Beitrag deshalb nur die eng belegte Aussage: In der internen Fallstudie wurden 118 Maschinen der Baujahre 1998 bis 2014 mit externer Sensorik und WatchMen betrachtet, wobei akustische Signale und Vibrationen mit dem tatsächlichen Maschinenbetrieb validiert wurden Fallstudie. Das ist ein Beispiel für einen großen Bestandspark unterschiedlicher Baujahre, aber kein Beweis dafür, dass jedes Werk denselben Pilotumfang oder dieselben Ergebnisse erwarten darf.
10 / PRAXISWISSEN
Was dieses Protokoll ergänzt – und was nicht
Dieser Beitrag ersetzt bewusst keine bestehenden Novo-Texte, sondern schließt die Lücke davor. Wenn Sie bereits im Rollout oder in der formalen Freigabe sind, ist das MDE-Abnahmeprotokoll die passendere Vertiefung. Wenn Ihr Hauptproblem ein schneller Brownfield-Einstieg ohne große IT ist, lesen Sie Maschinenüberwachung ohne IT-Kenntnisse. Und wenn Sie Lösungsarten systematisch vergleichen wollen, ist der Produktionsmonitoring-Systemvergleich näher an dieser Frage.
Der eigene Mehrwert dieses Beitrags liegt deshalb nicht in einer weiteren allgemeinen Einführung, sondern in der Kombination aus Freigabefrage, Datenvertrag, Ground-Truth-Stichprobe, Bedienaufwand-Log, IT/OT-Check und Go/No-Go-Matrix für zwei bis sechs Wochen. Genau diese Verbindung fehlt häufig zwischen „einfach starten“ und „formell abnehmen“. Ein guter Pilot braucht beides: pragmatischen Einstieg und harte Entscheidungskriterien.
Die Grenzen des Protokolls sollten Sie offen mitnehmen. Erstens ersetzt Dokumentation keinen eigenen Werksversuch. Zweitens sagen Standardschnittstellen und Sensorbeschreibungen nichts darüber aus, wie sauber ein konkreter Bestand heute implementiert ist. Drittens ist eine beobachtete Pilotmaschine noch kein Beweis für alle Maschinen derselben Halle. Und viertens kann ein Pilot für Zustandszeiten tragfähig sein, ohne bereits für OEE, Ursachen oder Auftragskalkulation freigabefähig zu sein.
Wenn Sie diese Grenzen im Review nicht als Schwäche, sondern als saubere Entscheidungsgrundlage behandeln, erfüllt ein Maschinenüberwachung-Pilot seinen Zweck. Er beweist dann nicht zu viel, aber genau genug: ob Datenqualität, OT-Tauglichkeit, Aufwand und organisatorische Tragfähigkeit für den nächsten Schritt reichen. Mehr sollten vier Wochen auch nicht versprechen.
11 / PRAXISWISSEN
Pilotfreigabe vor Woche 1
Haken Sie ab, was Sie bereits geklärt haben. Die Auswahl bleibt nur während dieses Seitenbesuchs bestehen.
12 / PRAXISWISSEN
Weiterführende Fragen
Das kann reichen, wenn der Nutzungszweck eng gefasst ist und die Stichprobe gezielt kritische Randfälle abdeckt. Für Schichtvergleich, Bedienaufwand und wiederkehrende Grenzfälle ist ein vierwöchiger Takt belastbarer, weil mehr reale Alltagssituationen auftreten können.
Für eine belastbare Aussage ist eine kleine, aber bewusst gemischte Gruppe sinnvoll: mindestens eine stabile Referenzmaschine, eine problematische Maschine und eine ältere oder organisatorisch wichtige Bestandsmaschine. Zu viele Maschinen verwässern im Pilot die Gegenprüfung und das Fehlerlog.
Nein. Ein Pilot kann sinnvoll sein, auch wenn zunächst nur Zustandszeiten, Schichttransparenz oder längere Stillstände belastbar freigegeben werden. OEE, Ursachenlogik oder Auftragsbezug sollten nur dann freigegeben werden, wenn die dafür nötigen Datenquellen und Zeitregeln ebenfalls geprüft wurden.